模型打印
已Llama-7B hugging face版本为例:
1 | import torch |
1 | LlamaForCausalLM( |
从结构可以看出来,模型参数量为 。所以约为。
模型图解
以输入为 10 个 token 为例:
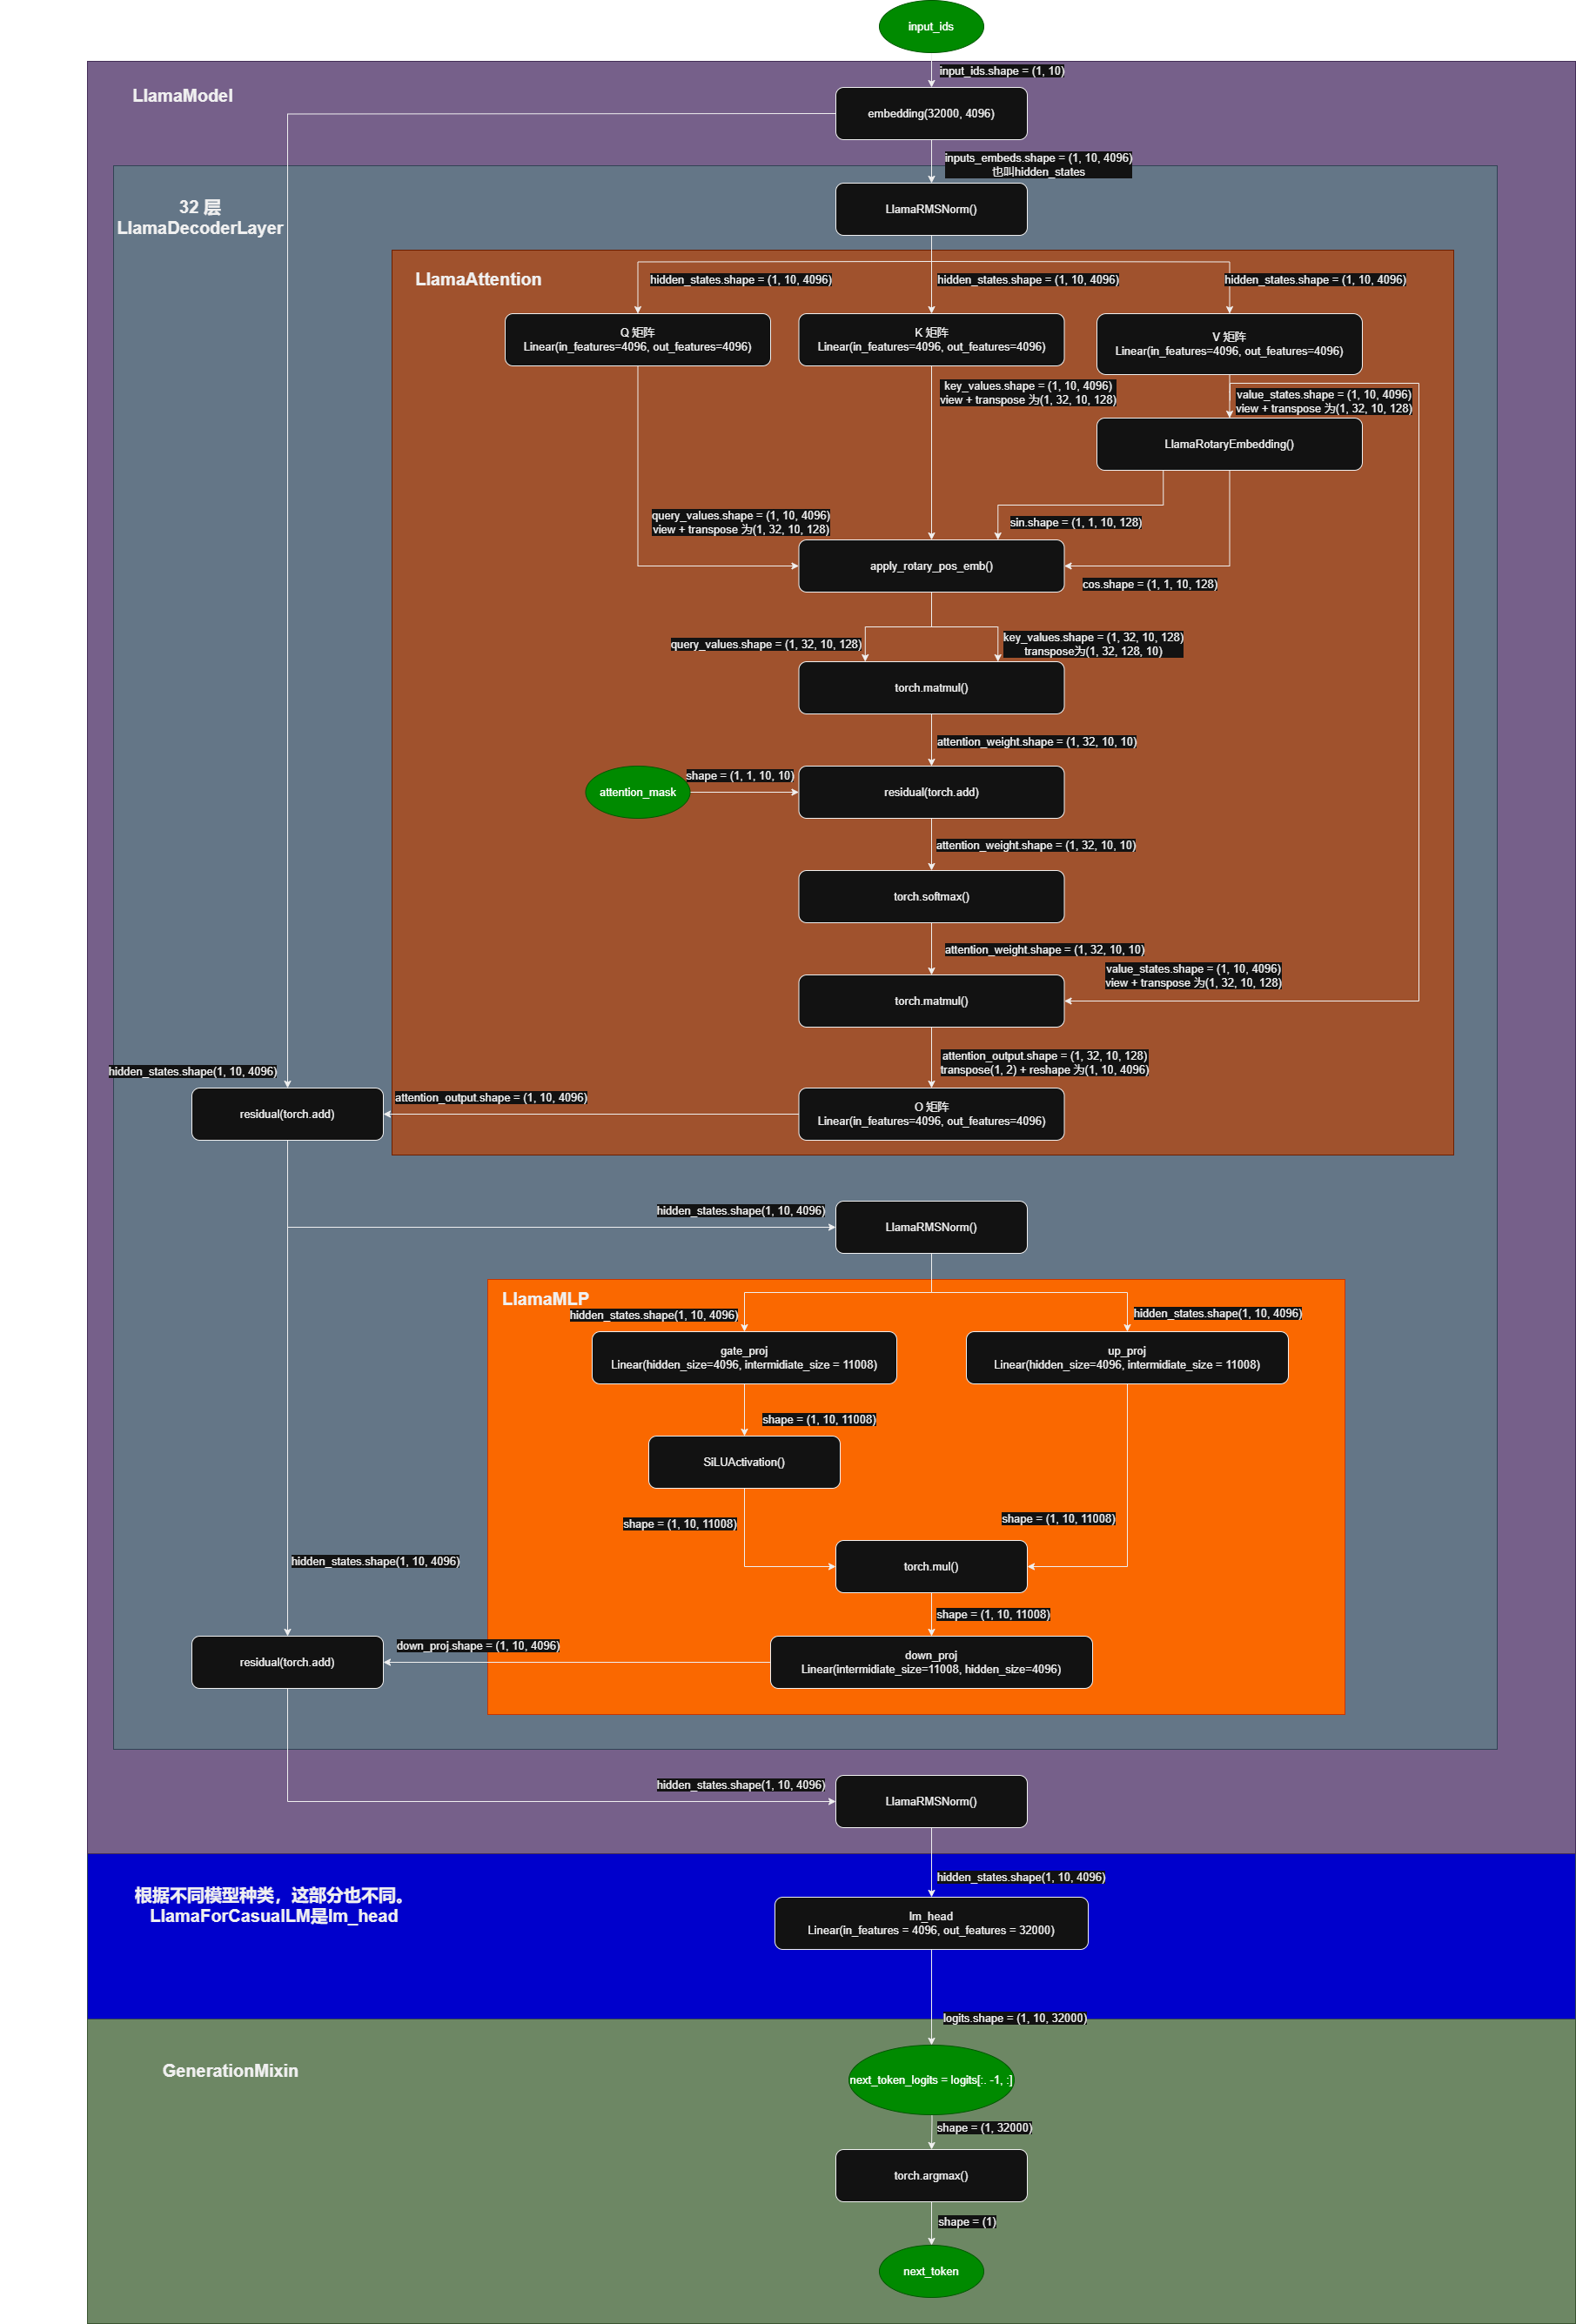
已Llama-7B hugging face版本为例:
1 | import torch |
1 | LlamaForCausalLM( |
从结构可以看出来,模型参数量为 。所以约为。
以输入为 10 个 token 为例:
是 gcc 的编译器指令,用于设置在 shared object 中所修饰的符号对外的可见性。该修饰对 .a 文件不生效,只对 .so 库生效。
该修饰用于修饰符号的可见性为默认对外可见。意思是通过该符号修饰的函数可以在 so 文件外访问到。
func.cpp:
1 | __attribute__ ((visibility("default"))) void func1(int a) { |
main.cpp:
1 |
|
1 | @└────> g++ func.cpp --shared -fPIC -o libfunc.so |
之后发现是可以编译成功的。因为该符号是可见的。
1 | @└────> nm libfunc.so | grep func |
大写的 T 表示定义在 text 段,并且可被外部引用。如果你是通过编译 .o 文件再链接为 .so 文件的,还可以使用 readelf -s 查看 .o 文件的可见性.
该修饰用于修饰符号的可见性为默认对外不可见。意思是通过该符号修饰的函数不可以在 so 文件外访问到,只能在 so 文件内部访问到。
func.cpp:
1 | __attribute__ ((visibility("hidden"))) void func2(int a) { |
main.cpp:
1 |
|
1 | @└────> g++ func.cpp --shared -fPIC -o libfunc.so |
之后发现是可以编译失败,因为符号不可见.
1 | @└────> nm libfunc.so | grep func |
1 | __attribute__ ((visibility("internal"))) |
上述两种一样是用于修饰符号, internal 对外不可见,而 protected 对外可见。
此外,在编译 so 文件时可以通过指定 -fvisibility=xxx 来指定默认的没有给出修饰的符号属性。
如:
1 | @└────> gcc -fPIC -shared -o libtest.so -fvisibility=hidden test.c |
这样在 test.c 中没用经过修饰的符号对外都不可见,而修饰为 default 的依旧对外可见。
在 ELF 文件中,查看可以获得它的节的名字。其中有几个带有 plt 和 got 的节。
在此处,给出各节的定义如下:
接下来将使用 gdb 一步一步跟着汇编走完动态链接的过程。
1 |
|
1 | @└────> # objdump -h plt | grep -E "plt|got" |
1 | @└────> # readelf -r plt |
1 | @└────> # objdump -d plt |
1 | @(gdb) disassemble main |
可以看到,调用处实际上是使用 call 指令走到 puts 的代码段。下面的 printf 也是如出一辙。
1 | @(gdb) disassemble |
可以看到,在汇编中,他首先要跳转到 0x601018 地址的位置。这个地址内容是个全局变量,实际上根据节的地址位置和大小可以判断,是处于 .got.plt 的位置内( 0x601000 ~ 0x601028)。所以可以认为,在 .got.plt 中,存在了 puts 函数的地址。
1 | @(gdb) x/16x 0x601018 |
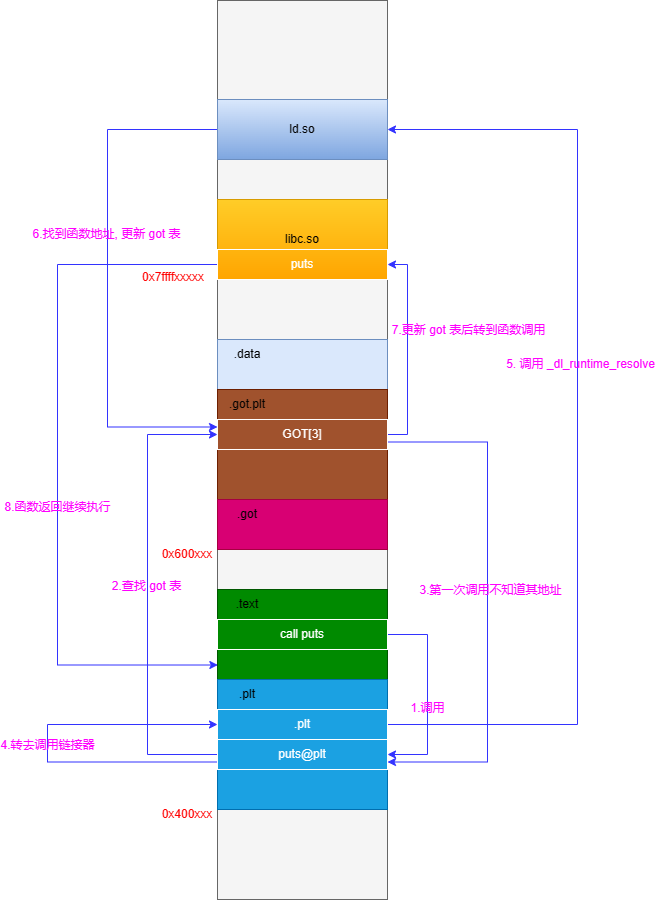
查看表中内容,发现跳转的地址是 0x4004d6,这不就是我们跳转之前的下一个地址吗!(puts@plt 的第二条指令) 同理,printf 函数也是如此(0x4004e6)。这是因为,之前没有调用过 puts 函数,第一次查找的时候,.got.plt 表中找不到函数的地址,那就先返回继续执行去调用链接器获取地址。
1 | 00000000004004d0 <puts@plt>: |
首先 pushq $0x0,这个是在 got.plt 中的编号,如 puts 是 0,printf 是 1。这个参数是给后续链接器使用的。然后跳到了 .plt 的位置执行(0x4004c0)。可以看到,printf@plt 函数最后也是跳到这个位置执行。
1 | 00000000004004c0 <.plt>: |
首先 push 了 0x601008 到栈中,这是 .got.plt 表中的一个地址。之后跳转到 0x601010 所存储的地址去执行相应的代码。不难看出,0x601010 也是存储在 .got.plt 表中的。查看一下存储的内容:
1 | @(gdb) x/10x 0x601010 |
可以看到,是让我们跳转到 0x00007ffff7de64a0 去执行相应的代码。那么这块代码是什么呢?
1 | @(gdb) info sharedlibrary |
可以看到,该地址是 ld-linux-x86-64.so 加载的位置。说明执行的是链接器的代码。
1 | 1: x/5i $pc |
可以看到这里代码执行的是 ld 中的 _dl_runtime_resolve_xsavec 函数是第一次函数调用时用于查找函数符号的,并且在结尾处会直接去调用找到的函数符号(本文中为 puts 函数)。
1 | @(gdb) bt |
可以看到,此时,got.plt 表中的地址已经被写为 puts 函数实际的地址了(0x00007ffff7a7d8c0 在 0x00007ffff7a2cb90 ~ 0x00007ffff7b798ad 范围内,属于 /lib64/libc.so.6),这样下次调用 puts 就不用再次调用链接器了。
其实看一下 .got.plt 表的内容,会发现明明 puts 是第一个需要被链接的函数,为什么第一个却不是它呢?
1 | @(gdb) x/10x 0x601000 |
puts 地址实际上是 got[3]:0x00007ffff7a7d8c0,前面还有 3 项。其中:
1 | @(gdb) info symbol 0x0000000000600e10 |
got[1]:0x00007ffff7ffe1d0 本模块的 link_map 的地址。编译期间会初始化为 0。link_map 是一个双向链表的入口,链接进程所有加载的动态库。当链接器查找符号时,通过遍历该链表找到对应的符号。
got[2]:0x00007ffff7de64a0 _dl_runtime_resolve_xsavec 的地址。
1 | @(gdb) info symbol 0x00007ffff7de64a0 |
_dl_runtime_resolve 格式:
1 | //调用形式为: |
虚拟地址空间内流程图:
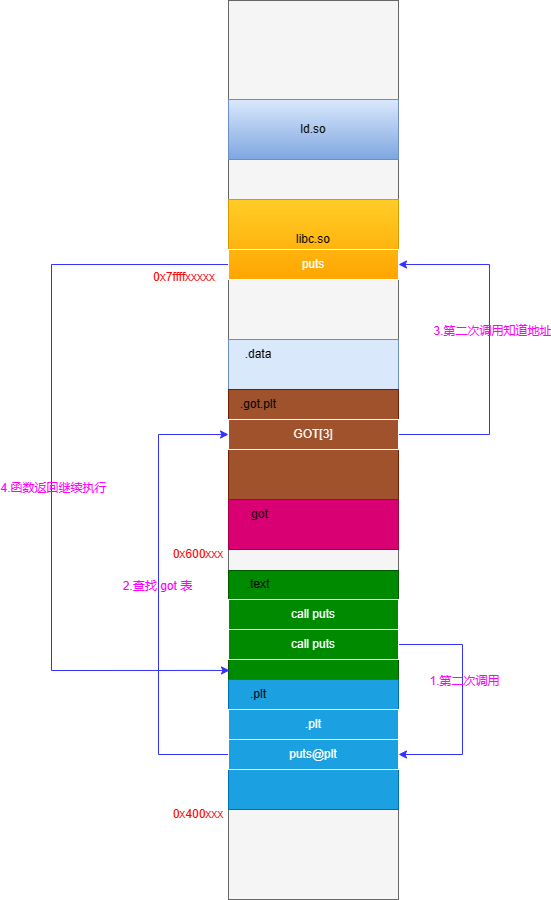
第二次调用:
内嵌汇编通常用于在程序中实现一些高效、精确的操作。例如,在嵌入式平台上运行的程序,如果需要代码占用内存更小、程序运行的效率更高或需要准确地操作寄存器时,嵌入汇编会是不错的选择。
1 | asm("assembly code" /* 汇编代码 */ |
在被改变的参数列表 clobbered_operand 中有一个比较有用的标识符:memory。指定 memory,相当于对编译器形成了一个内存读写的屏障,保证在内联汇编执行前,编译器将某些寄存器里的值刷新进内存,同时在内联汇编执行后,编译器重新加载相关变量的值。
所以我们可以见到这样的代码:
1 | asm volatile ("" ::: "memory"); |
作为内存屏障,保证编译器的优化不会跨过这道屏障。加上 volatile 告诉编译器不要优化汇编。
修饰符一般跟在参数列表前面。
| 修饰符 | 含义 |
|---|---|
| = | 只写,常用于修饰所有输出操作数 |
| 无 | 只读 |
| + | 可读可写 |
| r | 可以是任意通用寄存器存储其值 |
| m | 一个有效的内存地址 |
| i | 是立即数 |
| % | 被修饰的操作数可以和下一个互换 |
| & | 只能做输出,一般和 “=” 一起使用,如 “=&r(val)” |
| x | 只能做输入 |
%0 表示输入和输出列表合并的第 1 个操作数,%1 表示第 2 个,以此类推。
现代机器都是多个处理器,每个处理器有自己的 cache。这个结构如下所示:
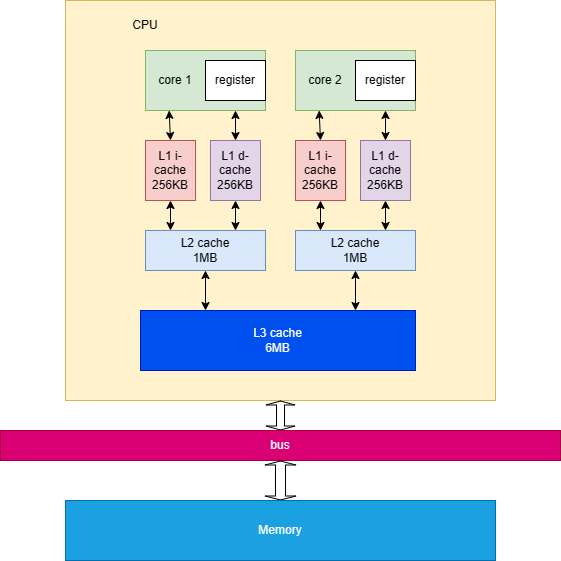
可以看到,每个 CPU 都有自己的缓存,之后再写到内存中。并且由于编译器的优化,你写的代码可能和你执行的代码顺序有所不同。他们优化的规则是:保证对于一个单核情况下,执行结果不会发生变化。但是多线程就不一定了。
那么在多线程情况下,如何协调这些 CPU 缓存的数据一致性就成了一个问题。
再谈保证数据的一致性之前,先谈谈编译器能做的优化。
编译器和 CPU 都会发生重排,为了提升代码的效率。采用乱序执行、流水线、分支预测以及多级缓存等方法来提升程序性能。编译器会基于这些规则来提升自己代码的速度,所以就会对指令进行优化。例子如下:
1 | int a = 0; |
1 | @└────> # gcc 1.c -O0 -g |
为什么要这么做呢?因为 CPU 读取数据从 cache 中读取。如果不优化的话,先读 b,再读 a 的时候可能把 b 的缓存换出去了,那么再写 b 的时候还需要把 b 换进来。但是如果优化了,就是读 b,写 b,再写 a,就不存在缓存的换入换出了。
假设有如下代码:
1 | for (int i = 0; i < n; ++i) { |
可能优化成如下:
1 | for (int i = 0; i < n; ++i) { |
预读取这些数据来减少缓存未命中次数。
删除很好理解了,删除没用的变量赋值。
1 | int x = 1; |
优化后:
1 | int x; |
sequence-before 是对一个线程内,求值顺序关系的描述:
描述的是不同线程内的执行关系。在两个线程分别执行时,即使线程 A 先执行,线程 B 后执行,A 中写了某个共享变量,由于指令重排或者写到了 cache 或寄存器没来得及写入内存导致 B 读到了错误的值。
是 sequence-before 的扩展,包括了不同线程的关系。
C++11 中引入了 6 种内存序:
1 | typedef enum memory_order { |
| 内存序类型 | 用于读/写 | 含义 |
|---|---|---|
| memory_order_relaxed | 读/写 | 仅要求原子性和内存一致性 |
| memory_order_consume | 读 | 读操作所在线程该操作后面的和该变量 有依赖关系的 读写操作不会被优化到先于该操作执行 |
| memory_order_acquire | 读 | 读操作所在线程该操作后面的读写操作不会被优化到先于该操作执行 |
| memory_order_release | 写 | 写操作所在线程该操作前面的读写操作不会被优化到后于该操作执行 |
| memory_order_acq_rel | 读/写 | 是 memory_order_acquire 和 memory_order_release 组成的双向屏障,上下皆不能跨过该指令 |
| memory_order_seq_cst | 读/写 | 双向屏障,并且该线程所有原子指令并且也指定为 memory_order_seq_cst 的都已全局内存修改顺序为参照 |
值得一提的是,若一个原子变量在一个线程中施加了 memory_order_release,但是在其他线程中没有使用 memory_order_acquire 或 memory_order_consume 读取,那么他就不会具备 memory_order_release 所赋予的屏障功能。(即只有被观测才会起作用,读操作也是如此)
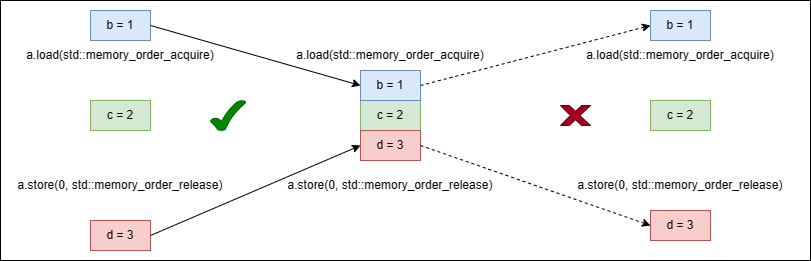
如上图所示,就像加锁一样会构成临界区。但是外面的变量可以移入临界区,却不能移出去,所以称 memory_order_acquire 和 memory_order_release 如同单向屏障一般。
一言以蔽之,引入内存模型的原因,有以下几个原因:
从上面的内存序中,按照访问控制的角度可以分为三种模型:
其中,Sequential Consistency 模型约束最强,Acquire-Release 次之,Relax 模型最弱。
对应 memory_order_seq_cst 内存序。Sequential Consistency 模型有以下特点:
例如:
1 | x = y = 0; |
那么可能的执行顺序为:
| 可能性 | 第一步 | 第二步 | 第三步 | 第四步 |
|---|---|---|---|---|
| 1 | x = 1 | r1 = y | y = 1 | r2 = x |
| 2 | y = 1 | r2 = x | x = 1 | r1 = y |
| 3 | x = 1 | y = 1 | r1 = y | r2 = x |
| 4 | x = 1 | r2 = x | y = 1 | r1 = y |
| 5 | y = 1 | x = 1 | r1 = y | r2 = x |
| 6 | y = 1 | x = 1 | r2 = x | r1 = y |
std::atomic 默认值都是使用 memory_order_seq_cst,保证不出错。但是相对的,限制了 CPU 并行处理的能力,会降低效率。这个模型的所有线程都参考全局的内存修改顺序。因此,我们可认为所有变量的读写都直接从内存进行,从而完全不用考虑 Cache,Store Buffer 这些因素。
对应 memory_order_consume、memory_order_acquire、memory_order_release、memory_order_acq_rel 内存序。对于一个原子变量 A,对 A 的写操作(Release)和读操作(Acquire)之间进行同步,并建立排序约束关系,即对于写操作(release)X,在写操作 X 之前的所有读写指令都不能放到写操作 X 之后;对于读操作(acquire)Y,在读操作 Y 之后的所有读写指令都不能放到读操作 Y 之前。
对应的是 memory_order_relaxed 内存序。其对于内存序的限制最小,也就是说这种方式只能保证当前的数据访问是原子操作(不会被其他线程的操作打断),但是对内存访问顺序没有任何约束,也就是说对不同的数据的读写可能会被重新排序。
本文用以记录常用汇编指令以供快速查找回忆,仅限于 X86_64 的 AT&T 格式。
1 | mov %rsp, %rbp |
对于访问内存的数据,指令后加上 b w l q,操作 1 2 4 8 字节。如
1 | movb $0x1,0x201c3f(%rip) |
1 | movl $1, %eax |
从源操作数到目的操作数,如下将 %rsp 寄存器中的数传给 %rbp 寄存器。
1 | mov %rsp,%rbp |
| 命令 | 数据类型 |
|---|---|
| .ascii | 文本字符串 |
| .asciz | 以空字符串结尾的文本字符串 |
| .byte | 字节值 |
| .double | 双精度浮点数 |
| .float | 单精度浮点数 |
| .single | 单精度浮点数同上 |
| .int | 32位整数 |
| .long | 32位整数同上 |
| .octa | 16字节整数 |
| .quad | 8字节整数 |
| .short | 16位整数 |
| .comm | 声明未初始化的数据的通用内存区域 |
| .lcomm | 声明未初始化的数据的本地通用内存区域 |
| 命令 | 作用 |
|---|---|
| .org | 定义当前汇编位置 |
| .globl | 让段全局可见 |
| .text | 存放代码指令正文段 |
| .bss | 存放未初始化的全局和静态变量,运行时该区域初始化为 0 |
| .rodata | read only data |
| .data | 可读可写的数据段 |
1 | mov $0x8000,%eax |
1 | movl $0x8000,%ebx |
1 | movl $0x8000,%eax |
1 | movl $0x8000,%eax |
1 | movl $0x2000,%eax |
1 | mov %rsp,%rbp ; %rbp = %rsp |
1 | addl %eax,%ebx ; %ebx = %ebx + %eax |
1 | subl %eax,%ebx ; %ebx = %ebx - %eax |
1 | incl %eax ; %eax = %eax + 1 |
1 | decl %eax ; %eax = %eax - 1 |
1 | pushl %eax ; 入栈,%esp = %esp - 0x4, %esp = %eax |
1 | popl %eax ; 出栈,%eax = %esp, %esp = %esp + 0x4 |
1 | jmp label ; 无条件跳转为 label, %rip = label |
1 | imull %eax,%ebx ; %ebx = %eax * %ebx 用于有符号数 |
1 | idivl %ebx ; %edx = %eax % %ebx, %eax = %eax / %ebx 用于有符号数 |
1 | andl %eax,%ebx ; %ebx = %ebx & %eax |
1 | orl %eax,%ebx ; %ebx = %ebx | %eax |
1 | xorl %eax,%ebx ; %ebx = %eax ^ %ebx |
1 | shll $1,%eax ; %eax = %eax << 1 逻辑左移,填充 0 |
1 | shrl $1,%eax ; %eax = %eax >> 1 逻辑右移,填充 0 |
1 | leal 8(%ebx),%eax ; %eax = 8 + %ebx 可理解为 %eax = &(*(%ebx)) + 8 |
1 | call func_name ; 将下一条指令的 %rip push 到栈中,之后 %rip = func_name |
1 | ret ; 将函数返回地址的下一条要执行指令的值赋值给 %rip,push %rip |
1 | testl %eax,%ebx ; %eax & %ebx,不会改变这两个寄存器值,改变标志寄存器零标志位(ZF)、符号标志位(SF)、奇偶标志位(PF)和进位标志位(CF),但不会影响溢出标志位(OF) |
1 | cmpl %eax,%ebx ; 根据 %ebx - %eax 的值来改变零标志位(ZF)、符号标志位(SF)、奇偶标志位(PF)、进位标志位(CF)和溢出标志位(OF) |
1 | repz movsb ; 重复执行 movsb 直到 ZF = 0 |
1 | lock addl $1,(%eax) ; 锁定总线,并使 *(%eax) = *(%eax) + 1,因为总线是锁定的,不会被其他处理器打断 |
1 | xaddl %eax,%ebx ; tmp = %eax,%eax = %ebx,%ebx = tmp + %ebx 交换两个数,并将和写到 %ebx |
1 | nop ; 什么都不做,充当占位符或者插入延迟 |
1 | hlt ; 使处理器进入暂停状态,直到发生外部中断。它通常用于操作系统内核中,以降低功耗和发热量。只有特权级别为 0 (内核态) 才能使用,否则会导致异常 |
1 | xchgl %eax,%ebx ; tmp = %eax,%eax = %ebx,%ebx = tmp |
1 | cld ; 清除方向寄存器,使 %rdi 递增 |
1 | movsb ; 以 %rsi 为源地址,%rdi 为目的地址,将字符以一个字节拷贝。每次执行 movsb,%rsi 和 %rdi 以方向标志寄存器(DF)自动递增或递减 |
1 | scasb ; 将被查找字符放到 %al 中,与 %rdi 地址的字符串依次比较,根据比较结果设置标志寄存器 |
1 | cli ; 禁用所用中断 |
今天调试代码的时候看到地址的时候突然感到奇怪:我记得我之前看到的代码地址空间好多都是 0x400xxx 开头的,怎么这次的地址空间是 0x5562b845axxx 呢?是什么导致了这个差异?
我换了地址空间为 0x400xxx 开头的机器,准备了相同的代码,在两台不同的机器上编译:
1 |
|
这个简单的程序可以打出 main 函数的地址。经测试,在不同的机上打出的结果有很大差异。
1 | @└────> # ./a.out |
经查阅资料,这个问题是 Linux 的 ASLR (Address Space Layout Randomization)导致的。这项技术会在装载时,装载到随机地址,防止黑客利用固定地址注入恶意代码。对于 b.out,没有使用该技术。所以 b.out 的代码段虚拟地址一直是 0x400000 开头。
1 | @└────> # readelf -h b.out |
可以看到,对于 b.out,他的文件类型是 Executable file,_start 的地址是 0x400xxx 开头。这种就是没有使用 ASLR 技术的。而对于 a.out,结果如下:
1 | @└────> # readelf -h a.out |
对于 a.out,文件类型为 Shared object file,而且 _start 的地址是个相对地址。就是这个导致的这个差异。每次装载 a.out 时,代码会被加载到随机的位置。可以看到,每次运行,得到的地址都不同。
1 | @└────> # ./a.out |
之所以发生这个原因,是因为操作系统版本导致的。低版本操作系统默认不使用 ASLR。想要在不同的操作系统上复现这两个方式也很简单:
1 | @└────> # gcc 1.c -fPIC -pie |
这种方式编译出来的就是使用了 ASLR 技术的。其中 -pie 的意思是 position-independent executable,位置无关的可执行文件。编译时还需要加上 -fPIC (Position-Independent Code)生成位置无关代码。而
1 | @└────> # gcc 1.c -no-pie |
方式编出来的就是固定地址。有些工具必须使用 -no-pie 才可以使用。这样固定的情况也比较好调试,因为虚拟地址固定。
标准情况下,这些文件描述符和以下设备关联:
在 shell 中,我们经常使用 > 符号,把输出重定位到一个文件。例如:
1 | cat /proc/xxx/maps > memory.txt |
以上输出是把某个进程的内存布局重定向到一个文件。其中,> 是 1> 的简写,实际意思是把标准输出重定向到后面的文件。这样屏幕上就不会有打印了,打印会重定向到文件中。
本质上,>& 符号不是一个符号。我们经常见到 2>&1 符号,实际意义是,将标准错误重新定位到标准输出。那为什么要加个 & 呢?因为不加 & 的话操作系统不会认为你是想把标准错误重定位给标准输出,而是想重定向到一个叫 “1” 的文件。所以 &1 表示 1 输出通道。举例,strace 命令可以查看系统调用,这个结果是输出到标准错误的。
1 | strace ls > log 2>&1 |
将标准输出重定向到 log 文件,并将标准错误重定向到标准输出。这样标准错误也会被重定向到 log 文件。
&> 意思是把标准错误和标准输出都重定向到某个文件。
1 | strace ls &> log |
写起来比较简单,且省力。
在 C 语言中,函数调用在底层汇编究竟发生了什么呢?示例如下:
1 | int add(int a, int b) { |
对上面这个文件编译的结果进行反汇编,这两个函数的反汇编结果如下:
1 | @└────> # objdump -d a.out |
可以看到,在函数调用时,发生了不同函数栈的切换。其中涉及到一些相关汇编指令。
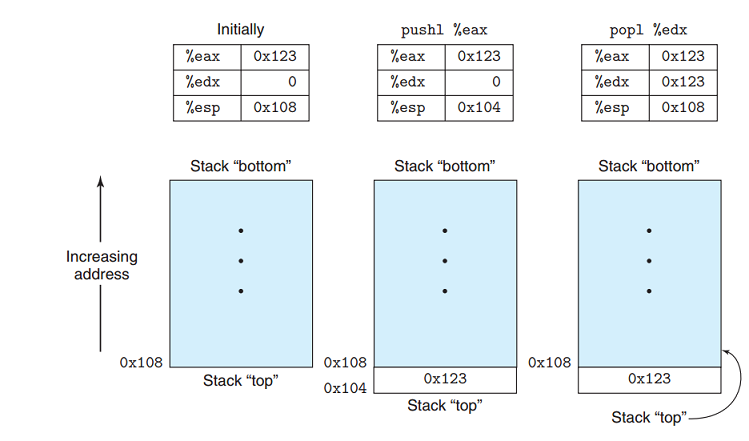
如上图所示,%rbp 寄存器和 %rsp 寄存器表示这一个栈的 “基址” 和 “栈顶”。因为栈是从高向低生长的,所以基址在栈顶上面。push 操作相当于,先将栈顶向下移动(因为存数据是向 %rsp 指向的位置写数据,而 %rsp 指向的是目前已有的栈顶数据),再将数据写入。pop 操作则相反。通过这两个寄存器,可以维护一个栈的存在。调用函数设计到栈的切换,所以就是通过改变这两个寄存器的值来达到切换的。
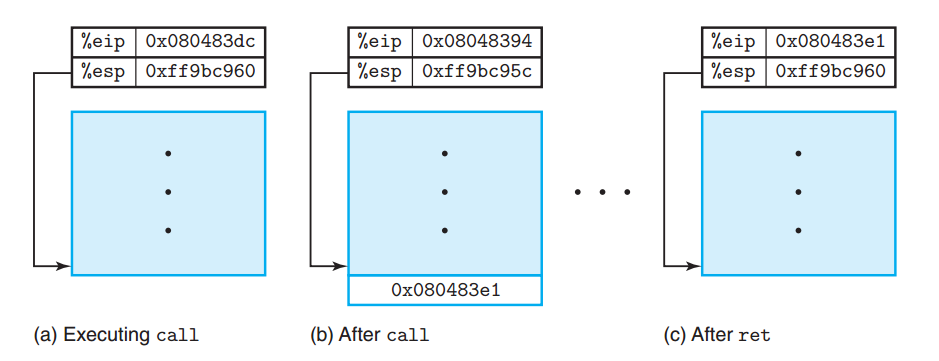
如上图所示,调用函数涉及到执行指令的切换。将要执行的下一条指令又由 %rip 寄存器指出。
call 指令可以改变 %rip 寄存器的值:将 call 汇编指令的下一条指令地址 push 到栈中,之后改变 %rip 为 call 的指令地址。
ret 指令也可以改变 %rip 寄存器的值:将栈顶元素 pop 给 %rip,将其改为之前 call 时存的下一条要执行的指令地址。
那么操作系统这一系列操作对于我们将递归算法转换为迭代算法有什么启发吗?
1 | vector<int> ret; |
上面是二叉树中序遍历的递归写法,非常简洁。其中可以看到在递归函数 helper 中,又调用了两次 helper。我们知道每次调用 helper,都有它自己的调用栈。那么我们向迭代转换时,就要注意不能让他们的调用栈互相冲突。那么我们可以自己定义一个状态变量,用来存储当前执行的函数栈。除此之外,还要知道当前栈执行到本次函数的哪个位置(%rip)。两次 helper 的执行,可以将整个调用结构分为三部分:
我们定义一个 state 结构体,用于充当存储函数局部变量和执行位置。改写后函数如下:
1 | typedef struct state { |
形式:
1 |
|
即,在构造函数后,使用列表的方式来初始化成员变量。
其实,列表初始化一直都在,只是我们在代码中忽略了。
示例:
1 |
|
结果:
1 | @└────> # ./a.out |
列表初始化顺序并不取决于在构造函数中列表的顺序,而取决于该成员在类中声明的顺序。
示例:
1 |
|
结果:
1 | @└────> # ./a.out |
1 |
|
输出:
1 | @└────> # ./a.out |
可以看到上面对于 A 来说,是先调用构造函数再调用赋值函数,而对于 B 来说就是拷贝构造函数。所以列表的形式是初始化,不同于在大括号内赋值。