一句话:把草稿模型从「自回归生成器」换成「块扩散填充器」—— 一次前向并行解出一整块 mask 位置;同时把目标模型的融合隐状态作为 KV 注入到草稿的每一层。输出分布与目标模型逐字解码完全一致。
归属:DFlash 出自 Z Lab / UCSD(Chen, Liang, Liu),论文 arXiv:2602.06036,ICML 2026。
符号约定
| 符号 | 含义 | 备注 |
|---|---|---|
| / | 目标模型 / 草稿模型 | 冻结 |
| 块大小(block size) | DFlash 默认 16;示例中取 8 | |
| 草稿模型层数 | DFlash 默认 5 | |
| 从目标模型抽取的隐状态层数 | DFlash 取 5 层 | |
| anchor:块的第 0 位,上一轮已验证的 token | 已知,不参与预测 | |
| 块内嵌入(含 与 mask 位) | 下标 = block | |
| 目标上下文融合特征 | 下标 = context | |
| / | 由 / 投影得到的 KV | 注意力中按序列维拼接 |
| 每轮接受长度(含 bonus token) | ||
| 草稿一次提出的候选数 | 自回归草稿中 |
一、瓶颈与成本模型
Decode 阶段每个 token 都要把全部权重从 HBM 搬进计算单元一次,而这一步算术强度极低 —— 计算单元大部分时间在等数据(memory-bound)。关键观察是:权重搬运这一趟的成本已经付了,却只换来 1 个 token。
投机解码的基本形式:用便宜的草稿模型 提出若干候选,交给目标模型 一次并行验证。DFlash 论文(§3.1)沿用的平均每 token 延迟与加速比为
其中 是验证开销, 是每轮期望接受长度(含目标模型顺带产出的 bonus token), 是整体加速比。 是逐字解码的每 token 延迟。这个式子把设计空间一次说清,论文原文也强调:要提高加速比,只能抬高 或压低 (DFlash §3.1)。
而在自回归草稿里,这两件事互相冲突。
自回归草稿:草稿是逐 token 生成的,第 个 token 必须等第 个算完,于是
成本随 线性增长。论文指出:为了让延迟可控,自回归草稿被迫使用极浅的架构(EAGLE-3 只有一层),这严重限制了草稿质量 —— 随 增加会迅速饱和。
块扩散草稿: 个位置在同一次前向内并行解出,
论文的表述是:对中等块大小,, 基本对 不敏感。这改变了设计空间 —— 草稿模型可以做得更深而不显著增加延迟。论文实测:一个 5 层 DFlash 草稿生成 16 个 token,延迟比单层 EAGLE-3 生成 8 个 token 更低,同时接受长度更高。
二、块扩散草稿:为什么能一次猜好几个
这是全文核心。先看清自回归为什么必须串行。
自回归的串行是结构性的
自回归草稿第 步的输入是 —— 第 步依赖第 步的输出。这是一条函数依赖链,硬件再并行也打不断。
扩散把它换成「条件」而非「依赖」
块扩散把「预测下一个 token」改写成「填补被 mask 的位置」。给定块
其中 是 anchor, 是 mask。所有 mask 位置共享同一份条件:
- 目标上下文特征 (见第三节);
- 块内所有位置的嵌入 (含 与其他 mask)。
关键在于: 之间没有互相依赖,它们只是共同以彼此为条件。注意力天然能同时互相可见 —— 只要块内做双向注意力、不加因果掩码。
于是 个位置变成一次并行求解,而不是 次串行求解。
注意力模式
设草稿第 层,块内嵌入为 ,上下文特征为 。该层的 Q 与拼接后的 KV 为:
其中
三个要点:
- 只来自块内(上下文特征不产生 query);
- 只作为额外的 KV 条目,绕过草稿的 Q 投影、输出投影、self-attention 更新与 FFN(论文 §A.3);
- 块内双向可见(推理时无因果掩码),因此 个位置互为条件、同时出结果。
一个常见的误解:这里没有「多步去噪」
经典扩散需要多步迭代去噪,这也是扩散模型做端到端生成时慢的原因。但 DFlash 的草稿是一步出整块的。因此草稿延迟是 而非若干步去噪之和。
代价:位置之间「不商量」
并行填充的固有代价是各位置独立决策,块内可能不连贯。这是「用并行换一致性」的显式权衡,不是实现瑕疵 —— 它直接引出了 DFlash 2(第六节)。
三、KV 注入:让目标信号贯穿每一层
草稿模型很小,猜不准的根本原因是缺乏上下文信息。前代方法(EAGLE 系列)已经会利用目标模型隐状态,但做法是输入融合:把目标特征与草稿 token 嵌入拼接后作为输入喂进去一次。
论文对这种做法的批评很直接:信号只在入口出现,随着草稿层数增加会被逐步稀释,导致加深草稿带来的接受长度收益递减。所以,DFlash 改为 KV 注入:从目标模型均匀抽取 层隐状态(论文实现取第 2 层到倒数第 3 层之间均匀 5 层),拼接后一次投影:
然后把 注入到每一个草稿层的 K/V(即上节的 )。论文的解释是:这让每一层都能重新看到目标上下文,信号不被深度稀释,因此接受长度可以随草稿层数持续增长。
复杂度与参数量(论文 §A.3):唯一新增的参数化组件是共享投影 加若干草稿层;论文给出的量级是约占目标模型 1.6%。 本身很小 —— 、、bf16 下约 42 MB,相对 70 GB 级目标模型可忽略。词嵌入表与 LM head 与目标模型共享并冻结。
消融证据
论文 Table 9 用同一套设定换掉注入方式(Qwen3-4B,,,单元格为 τ / 加速):
| 条件方式 | GSM8K | HumanEval | MT-Bench |
|---|---|---|---|
| 输入融合(EAGLE 式) | 3.5 / 2.9× | 3.5 / 2.9× | 2.6 / 2.0× |
| KV 注入(DFlash) | 4.2 / 3.3× | 4.0 / 3.2× | 3.0 / 2.2× |
论文还做了一个更干净的交叉验证:把 DFlash 草稿改回自回归、只保留 KV 注入(DFlash-AR),接受长度依然全面高于 EAGLE-3-5L。这说明「并行」与「注入」两个贡献是独立可测的,不是互相依赖的巧合。
四、推理流程
一轮四个动作:draft → verify → accept → rewind。
伪代码
草稿模块前向(KV 注入):
1 | def draft_forward(block_ids, H_c): |
一个完整推理周期:
1 | def dflash_cycle(prefix, target, draft, B=8): |
一个工程细节(有明确出处)
DFlash 把 提前投影成 KV,然后将这份投影后的 KV 存入草稿模型的 KV Cache 中,而不是把原始存进 cache。SGLang / Modal / Z Lab 的联合博客给出的两个理由是:不占用 KV cache 空间去存原始隐状态;且前缀相同的请求可以直接复用这份 cache(radix cache)。
六、改进
DFlash 2:补上并行的两个固有短板
2026 年 8 月,Inco AI(DFlash 原班人马)发布 DFlash 2。它不改变并行范式,而是修补并行草稿的两个弱点。以下数据均来自该博客。
短板一:块内不连贯。 每个位置独立取 top-1,可能出现语义打架的块(例如相邻两位都选中同一个词)。但博客给出的证据表明问题在选择而非预测:
| 指标 | 位置 0 | 位置 1 | 位置 2 | 位置 3 | 位置 4 | 位置 5 | 位置 6 | 接受长度 |
|---|---|---|---|---|---|---|---|---|
| top-1 命中率 | 85.4% | 80.3% | 79.4% | 78.3% | 77.5% | 75.9% | 72.9% | 4.27 |
| top-16 命中率 | 99.5% | 97.3% | 94.8% | 92.6% | 90.8% | 89.4% | 87.8% | 6.79 |
也就是说,正确答案几乎总在候选表里;一个总能从 top-16 里选对的「oracle」能把接受长度从 4.27 抬到 6.79 —— 这段差距是纯粹的选择余量。
DFlash 2 的做法:保留每位置 top- 候选,对相邻候选对打一个低秩双线性分数
第一项 是草稿自身的 logit,只依赖于当前位置 t 和候选 b ,与前一个候选 a 无关。
它通常表示 b 本身在该位置有多好,第二项衡量 跟在 后面有多合理。
短板二:块尾衰减(suffix decay)。 博客的诊断是:DFlash 的注意力身兼两职 —— 读块外上下文 + 建块内依赖,而后者被逐渐挤掉(块内注意力占比从 Layer 1 的 30% 降到 Layer 5 的 8%)。于是即使选择器完美,块尾的候选本身也在变差。
直觉解法是加深(15 层确实有效),但博客指出 15 层要多 3 倍参数、增加 15.2% 的周期延迟,太不划算。DFlash 2 改为分工:注意力继续读上下文,另加一个专管块内一致性的卷积模块,约 +3% 参数、+0.7% 延迟,块尾命中率接近 15 层模型。
合起来:每次验证多产出 16~25% 的 token,额外周期延迟约 1%。
七、小结
- 成本模型决定设计空间:加速要么抬高 ,要么压低 。自回归草稿让这两者冲突,块扩散让它们解耦。
- 块扩散为什么能一次出多个:它把「token 之间的函数依赖」换成「mask 位置之间的共同条件」。依赖是串行的,共同条件是可并行的 —— 块内双向注意力把这件事表达出来。
- KV 注入解决加深的收益问题:目标特征作为额外 KV 条目贯穿每一层,信号不被深度稀释,接受长度才能随层数增长。论文的消融显示它与「并行」的贡献互相独立。
- 这里没有多步去噪:块内所有 mask 位置在单次前向里一起解出,这是它能当草稿的前提。
- 并行的代价是块内不一致,需要选择器或专用模块兜底。DFlash 2 证明这块短板可以用极小的参数代价补掉 —— 补短板比堆容量划算。
参考资料
DFlash 本体
- Chen, Liang, Liu,DFlash: Block Diffusion for Flash Speculative Decoding(Z Lab / UCSD,ICML 2026)— arXiv:2602.06036
- 成本模型公式:§3.1;注意力与并行草稿:§4.1;KV 注入与内存开销:§4.1、§A.3;无目标特征消融:§A.2
- 结果表:Table 1(主结果)、Table 3(SGLang 并发)、Table 6(层数)、Table 8(块大小)、Table 9(注入方式)
- 代码与模型:github.com/z-lab/dflash;HuggingFace DFlash 集合
- LMSYS / Modal / Z Lab,The next generation of speculative decoding: DFlash and Spec V2 — lmsys.org(SGLang 落地细节:KV 物化、前缀共享、融合 kernel)
DFlash 2
- Inco AI,DFlash 2: Keep Drafting Parallel — inco.ai/blog/dflash2
- 对照方法:Domino — arXiv:2605.29707;DSpark — arXiv:2607.05147
前代与背景
- Leviathan 等,Fast Inference from Transformers via Speculative Decoding — arXiv:2211.17192
- Cai 等,Medusa — arXiv:2401.10774
- Li 等,EAGLE — arXiv:2401.15077;EAGLE-2 — arXiv:2406.16858;EAGLE-3 — arXiv:2503.01840
- An 等,PARD — arXiv:2504.18583;Li 等,DiffuSpec — arXiv:2510.02358;Sandler 等,SpecDiff-2 — arXiv:2511.00606
- Arriola 等,Block Diffusion — arXiv:2503.09573
- Tencent,FastMTP — arXiv:2509.18362
工程落地
- 小米 MiMo × TileRT,MiMo-V2.5-Pro-UltraSpeed — mimo.xiaomi.com
- 开源权重:XiaomiMiMo/MiMo-V2.5-Pro-FP4-DFlash


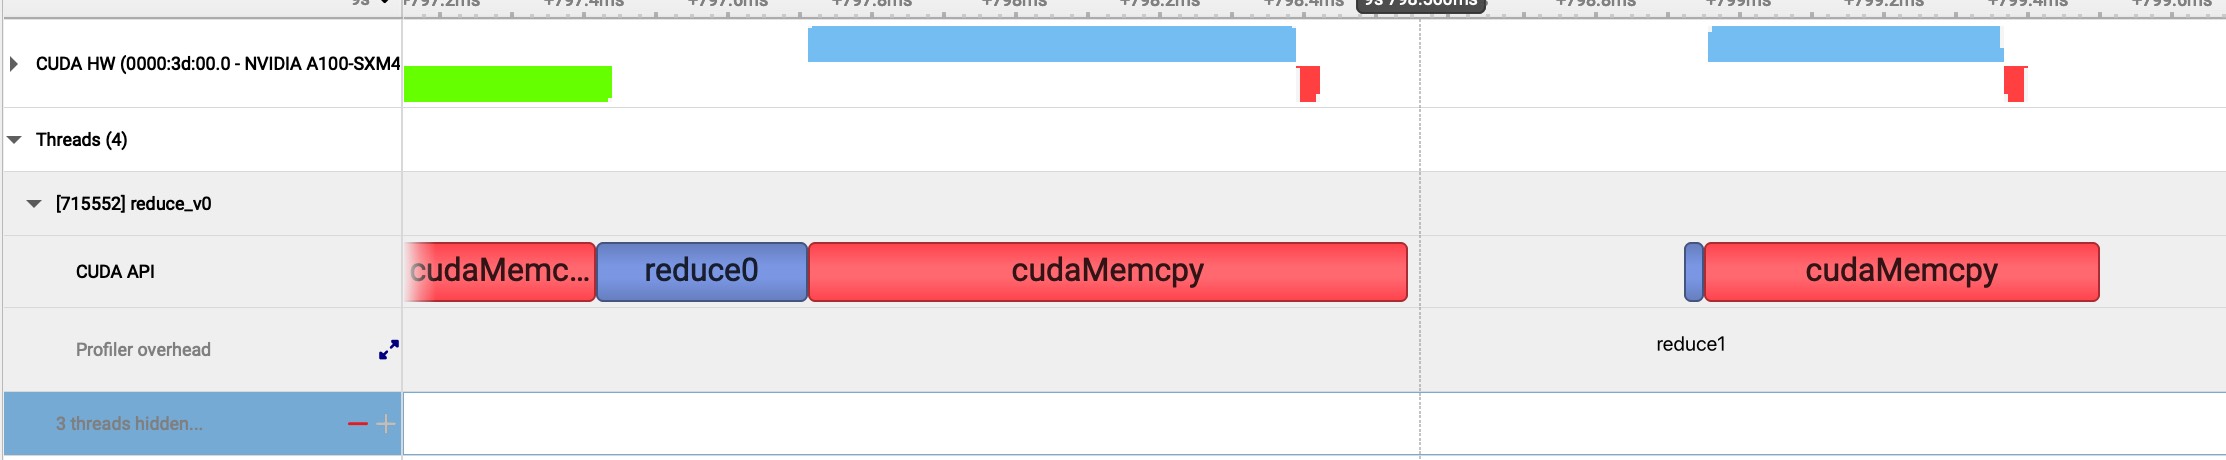 从上图可以看出 cuda hardware 的函数执行时间情况和 cpu 侧的执行时间情况。下面是核函数的发射时间,上面 device 侧是核函数实际执行时间,和 gpukernsum 统计的时间一致。
 上图是在软件中可以看见的较为详细的统计数据,和命令行结果一致。