mHC Manifold-Constrained Hyper-Connections
流形约束超连接,是 DeepSeek 团队在 2025 年 12 月提出,在 2026 年 4 月发布的 DeepSeek V4 中应用的新的残差技术,是 DeepSeek 的核心创新之一。他的目标是为了解决传统残差连接表达能力不足以及使用原始超链接(Hyper-Connections)深层次训练崩溃的问题。
1. 从 residual 到 mHC
mHC 是 Hyper-Connections(HC)的改进版,要解决的问题只有一句话:HC 让残差变强了,但丢掉了残差连接最关键的"恒等通路"。
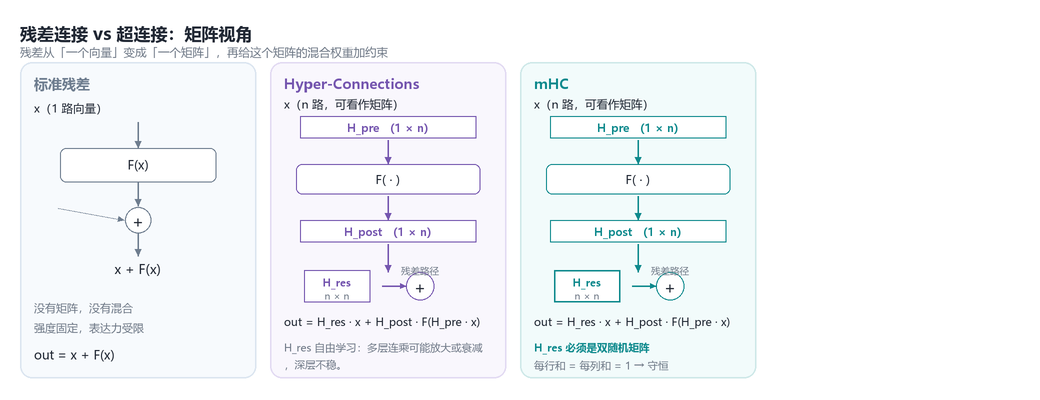
图 1:残差从「一个向量」变成「一个矩阵」。标准残差只有加法;HC 用 H_pre / H_post / H_res 三个矩阵管理读写与混合;mHC 只多做一件事——把 H_res 约束成双随机矩阵。
1.1 标准残差
这一项就是恒等映射:浅层信号不加修改地直达深层,反向梯度里也存在一条系数为 1 的通路,所以深层网络不会梯度消失。
代价是:透传比例写死为 1, 的强度无法自适应,信息通路单一。
1.2 Hyper-Connections:残差变成矩阵
HC 把残差从 1 路向量 拓宽成 n 路矩阵(n 称为 expansion rate。它让网络能够根据输入和深度,自适应地混合和分配信息,从而在训练稳定性和模型表达能力之间找到更优的平衡点。它用三个可学矩阵:
| 矩阵 | 形状 | 作用 | 本文代码里的 |
|---|---|---|---|
| 把 n 路残差聚合成 1 路,作为子层输入 | pre |
||
| 把子层的 1 路输出摊回 n 路 | post |
||
| 在残差路径上混合 n 路(只动流轴,逐 token 的小矩阵) | comb |
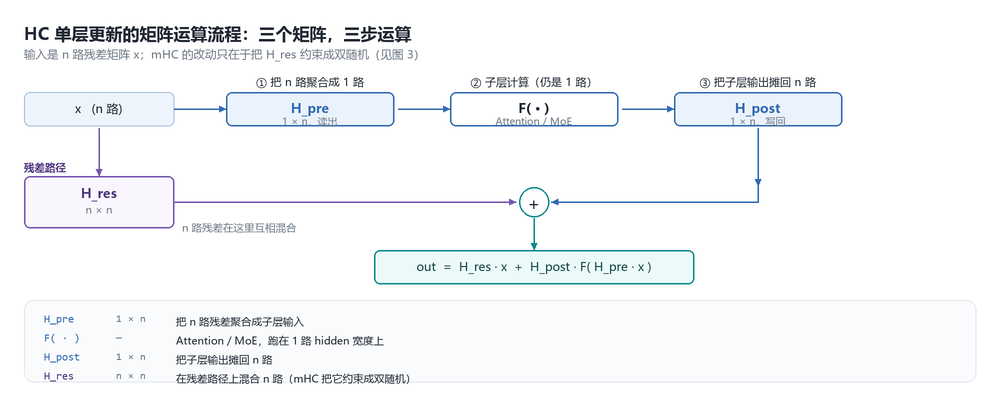
图 2:HC 单层更新里的三个矩阵、三步运算。子层 自己仍然只吃 1 路、跑在正常 hidden 宽度上,被加宽的是它外面那个残差矩阵;三个矩阵的系数 = 输入的动态部分 + 全局静态偏置。mHC 复用的是同一套流程,不同之处只有 被约束成双随机矩阵,见图 3。
这样残差的宽度就和层的输入宽度解耦了:加宽残差几乎不增加 的 FLOPs。消融显示三个矩阵里 贡献最大,也就是性能提升主要来自残差流内部的信息交换。
1.3 HC 为什么会在深层崩掉
把 HC 递归展开,浅层信号到深层要乘上一长串 :
标准残差里 前面的系数恒为 1,HC 里它变成了 。而 是自由学习的矩阵,没有任何约束保证这个连乘接近恒等:奇异值略大于 1 就指数放大,略小于 1 就指数衰减。论文实测该连乘的增益峰值到 3000 量级(理想值应为 1),同步出现的就是 loss 尖峰与梯度范数失控。
所以 HC 深层不稳定的根源不是某一层出了问题,而是"保范数的恒等通路"被换成了任意线性映射。
1.4 mHC:把 H_res 投影成双随机矩阵
mHC 不允许 自由生长,而是用 Sinkhorn-Knopp 算法把它投影到 Birkhoff 多面体——双随机矩阵构成的集合,即元素非负、每行每列之和都为 1。这就是"流形约束(Manifold-Constrained)"的含义。
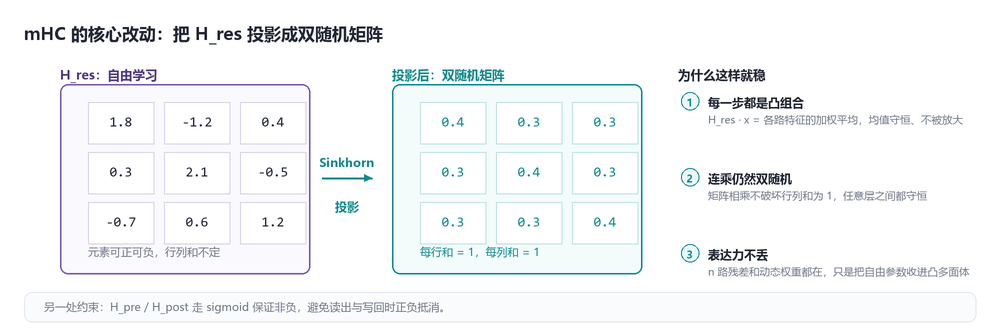
图 3:约束只作用在 comb 这个 矩阵上。先指数化,再交替做行归一化与列归一化(V4 发布配置迭代 20 次),收敛到双随机矩阵。
双随机正好补上 HC 缺的两条性质:
- 行和为 1 ⇒ 守恒: 是各路特征的凸组合,均值被保存、信号不被放大。这就是论文说的"恢复恒等映射性质"——恒等矩阵本身也是双随机矩阵。
- 对乘法封闭 ⇒ 任意深度都守恒:双随机矩阵相乘仍是双随机,所以 不会失控。这是"流形约束"和"调初始化 / 加正则"的本质区别。
另外两个矩阵用更松的约束,都是为了消除正负抵消:
| 矩阵 | 代码 | 约束 | 作用 |
|---|---|---|---|
pre |
sigmoid → 非负 | 从 n 路读出 1 路时不出现正负抵消 | |
post |
sigmoid 乘 2 → 非负有界 | 把 1 路写回 n 路时幅度可控 |
对照下文 hc_pre 的实现:mixes 被拆成三段,前两段过 sigmoid 得到 pre / post,第三段 reshape 成 后交给 sinkhorn_normalize 做"行归一化 → 列归一化"的交替迭代,收敛后得到的正是双随机的 comb。
1.5 小结
| 方法 | 残差 | 混合方式 | 关键性质 |
|---|---|---|---|
| 标准残差 | 1 路向量 | 无 | 恒等映射,守恒稳定,但强度写死 |
| HC | n 路矩阵 | 自由学习 | 残差内部可混合,但连乘无界 |
| mHC | n 路矩阵 | 双随机 | 守恒 + 可混合,可大规模稳定训练 |
mHC 保留了 HC"多路残差 + 内部混合"的表达力,只把混合矩阵限制在双随机流形上,把 HC 丢掉的守恒性拿了回来。V4 取 (Pro 每路 7168 维,Flash 每路 4096 维);加宽的残差要多读写显存,所以还要靠算子融合、选择性重计算、DualPipe 通信重叠压开销,端到端训练时间只增加约 6.7%。
2. 计算流程
以下代码来自 sglang 中的 deepseek v4 的 forward函数,省略了部分细节。
1 | residual = hidden_states |
可以看见,在最开始的时候会保存原始的 hidden_states(residual),之后对这部分 hidden_states 做预处理。这里的 residual 就是第 1 节里的 (n 路残差矩阵),hc_pre 负责算出 、、 三个矩阵,hc_post 完成的正是 这一步。
hc_pre
对于 hc_pre 函数,可以看到有四个入参。
输入参数:
| 参数 | 类型 | 维度 | 说明 |
|---|---|---|---|
| x | torch.Tensor | […, hidden_size] | 输入激活值,通常是上一层输出 |
| hc_fn | torch.Tensor | [hc_mult, hidden_size] | 混合函数权重,定义了如何将输入映射到混合空间 |
| hc_scale | torch.Tensor | [hc_mult] | Sinkhorn 迭代的缩放因子 |
| hc_base | torch.Tensor | [hc_mult] | Sinkhorn 迭代的基础偏置项 |
返回值:
| 参数 | 类型 | 维度 | 说明 |
|---|---|---|---|
| y | torch.Tensor | […, hidden_size] | 预处理输出:对 x 按混合权重加权后的结果 |
| post | torch.Tensor | […, hc_mult] | 后处理权重:用于后续 hc_post 阶段 |
| comb | torch.Tensor | […, hc_mult, hc_mult] | 组合矩阵:表示各混合通道间的连接关系 |
具体计算分为两个步骤:
- 计算输入的归一化(rmsnorm),并与混合函数矩阵乘,映射得到混合权重。
1 | def hc_pre_torch_impl(x, hc_fn): |
这个函数将返回 mixes 交给下一步处理。
- Sinkhorn 归一化
Sinkhorn 归一化是一种快速迭代算法,用来将任意非负矩阵转换成双随机矩阵(每行和每列的和都等于 1)。它是 DeepSeek V4 mHC(流形约束超连接)架构中最核心的数学创新,解决了原始超连接训练崩溃的问题。hc_split_sinkhorn 的作用是将输入的 mixes 张量拆分为三部分(pre、post、comb),并对 comb 部分执行 Sinkhorn 归一化,使其收敛为双随机矩阵(doubly stochastic matrix)。
核心思想:交替对行和列进行归一化,直到收敛。
1 | pre, post, comb = hc_split_sinkhorn( |
输入参数:
| 参数名 | 类型 | 维度 | 输入/输出 | 说明 |
|---|---|---|---|---|
| mixes | float32 | (n, mix_hc) | 输入 | 混合参数,其中 mix_hc = (2 + hc) * hc |
| hc_scale | float32 | (3,) | 输入 | 三部分(pre/post/comb)的缩放系数 |
| hc_base | float32 | (mix_hc,) | 输入 | 基础偏置参数 |
| hc_mult | int | 标量 | 输入 | 隐藏维度参数,控制 pre/post/comb 的输出维度 |
| hc_sinkhorn_iters | int | 标量 | 输入 | Sinkhorn 归一化的迭代次数 |
| hc_eps | float | 标量 | 输入 | 数值稳定性参数,防止除零,用于 sigmoid 和归一化 |
输出参数:
| 参数名 | 类型 | 维度 | 输入/输出 | 说明 |
|---|---|---|---|---|
| pre | float32 | (n, hc) | 输出 | 前置参数,sigmoid 激活结果 |
| post | float32 | (n, hc) | 输出 | 后置参数,sigmoid 激活结果乘以 2 |
| comb | float32 | (n, hc, hc) | 输出 | 组合矩阵,经过 Sinkhorn 归一化的双随机矩阵 |
其中输出的 pre 和 post 是由 mixes、hc_scale 以及 hc_base 计算得到的(把 mixes 按 mult、mult、mult × mult 切成三段,分别记作 mixes₁ / mixes₂ / mixes₃):
三段的形状分别是 、、,合计 ,与上表里 mix_hc 的定义一致。comb 这一段 reshape 成 之后才进 Sinkhorn 迭代,最后得到的 矩阵每行、每列之和都是 1——这正是第 1.4 节说的"投影到双随机矩阵流形"。
在分出这三个 tensor 后,对最后一个 combination tensor 进行迭代的归一化:
1 | def sinkhorn_normalize(comb_frag: torch.Tensor, sinkhorn_iters: int, eps: float = 1e-6): |
hc_post
将注意力/FFN 的输出与残差进行加权组合,是 hc_pre 的逆操作。该部分是对 mhc 部分的后处理函数:
1 | def hc_post_torch_impl(x, residual, post, comb): |
输入参数:
| 参数 | 形状 | 含义 |
|---|---|---|
| x | (n, hidden_dim) | 当前层输出 |
| residual | (n, hc_mult, hidden_dim) | 来自 hc_pre 的多路残差 |
| post | (n, hc_mult) | 后处理权重 |
| comb | (n, hc_mult, hc_mult) | 组合权重矩阵 |
输出参数:
| 参数 | 形状 | 含义 |
|---|---|---|
| output | (n, hc_mult, hidden_dim) | 当前层输出 |
| 公式: |
拆开看就是两件事:post 把"子层算出来的那 1 路结果"按权重摊回每一路残差,comb 则决定"上一层的 n 路残差"如何重新混合成这一层的 n 路。前者对应第 1.2 节的 ,后者对应 (也就是经过 Sinkhorn 归一化的那个双随机矩阵)。
3. 总结
mhc 诞生主要为了解决:
- 传统残差连接表达能力不足
标准残差连接只是简单的 out = x + f(x),信息通路单一。
mHC 通过 hc_pre 将输入映射到多路混合空间(hc_mult 路),在 hc_post 阶段用 post 和 comb 对当前层输出和残差做加权组合,相当于同时维护了多条残差通路,增强了表征能力。 - 原始 Hyper-Connections 深层训练崩溃
纯超连接在深层网络中容易出现数值不稳定或训练崩溃。
mHC 的核心创新是引入 Sinkhorn 归一化:将组合矩阵 comb 约束为双随机矩阵(每行、每列和均为 1)。
这保证了多路残差之间的信息流动是均衡且稳定的,避免了权重爆炸或消失,从而解决了深层训练崩溃问题。