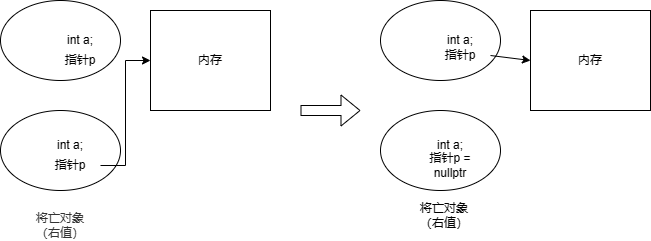
int t = 10; // t为左值 ++t; // t为左值,没有拷贝,这就是为什么 ++t 比 t++ 高效 t++; // t为右值,因为加之前的值是个将亡值,是个 t_copy,是个临时变量 int &&r = t; // 错误,右值不能绑定左值。
std::move()
实现代码
1 2 3 4 5 6 7 8 9
/** * @brief Convert a value to an rvalue. * @param __t A thing of arbitrary type. * @return The parameter cast to an rvalue-reference to allow moving it. */ template<typename _Tp> constexprtypename std::remove_reference<_Tp>::type&& move(_Tp&& __t)noexcept { returnstatic_cast<typename std::remove_reference<_Tp>::type&&>(__t); }
intmain(){ int a = 1; int b = 2; constint c = 1; constint d = 0; int &e = a; int &f = b; constint &g = c; constint &h = d; WithoutPerfectForward(a); // l + r = l WithoutPerfectForward(move(b)); // r + r = r WithoutPerfectForward(c); // const l + r = l WithoutPerfectForward(move(d)); // const r + r = r WithoutPerfectForward(e); // l ref + r = l WithoutPerfectForward(move(f)); // r ref + r = r WithoutPerfectForward(g); // const l ref + r = l WithoutPerfectForward(move(h)); // const r ref + r = r }
intmain(){ int a = 1; int b = 2; constint c = 1; constint d = 0; int &e = a; int &f = b; constint &g = c; constint &h = d; WithoutPerfectForward(a); // l + r WithoutPerfectForward(move(b)); // r + r WithoutPerfectForward(c); // const l + r WithoutPerfectForward(move(d)); // const r + r WithoutPerfectForward(e); // l ref + r WithoutPerfectForward(move(f)); // r ref + r WithoutPerfectForward(g); // const l ref + r WithoutPerfectForward(move(h)); // const r ref + r }
结果:
1
2
3
4
5
6
7
8
9
@└────> # ./a.out int & called! int & called! const int & called! const int & called! int & called! int & called! const int & called! const int & called!
可以看到虽然在函数 WithoutPerfectForward 中是右值,但是传给下一个函数的时候又默认都是左值了。虽然参数 t 是右值类型的,但此时 t 在内存中已经有了位置,所以 t 其实是个左值。
intmain(){ int a = 1; int b = 2; constint c = 1; constint d = 0; int &e = a; int &f = b; constint &g = c; constint &h = d; WithoutPerfectForward(a); // l + r WithoutPerfectForward(move(b)); // r + r WithoutPerfectForward(c); // const l + r WithoutPerfectForward(move(d)); // const r + r WithoutPerfectForward(e); // l ref + r WithoutPerfectForward(move(f)); // r ref + r WithoutPerfectForward(g); // const l ref + r WithoutPerfectForward(move(h)); // const r ref + r }
结果:
1 2 3 4 5 6 7 8 9
@└────> # ./a.out
int & called!
int && called!
const int & called!
const int && called!
int & called!
int && called!
const int & called!
const int && called!
/** * @brief Forward an lvalue. * @return The parameter cast to the specified type. * * This function is used to implement "perfect forwarding". */ template<typename _Tp> constexpr _Tp&& forward(typename std::remove_reference<_Tp>::type& __t)noexcept { returnstatic_cast<_Tp&&>(__t); }
/** * @brief Forward an rvalue. * @return The parameter cast to the specified type. * * This function is used to implement "perfect forwarding". */ template<typename _Tp> constexpr _Tp&& forward(typename std::remove_reference<_Tp>::type&& __t)noexcept { static_assert(!std::is_lvalue_reference<_Tp>::value, "template argument" " substituting _Tp is an lvalue reference type"); returnstatic_cast<_Tp&&>(__t); }
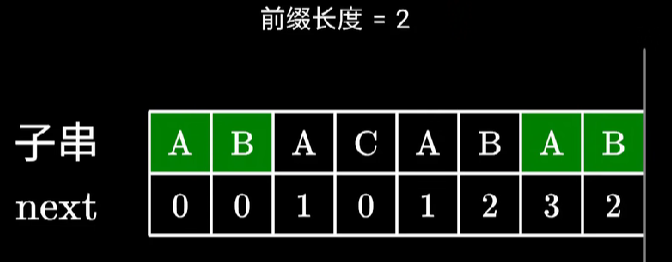
next 数组的本质是寻找子串中“相同前后缀的长度,并且最长”。并且不能是字符串本身。举个例子而言,如下所示:
A
B
A
B
C
0
0
1
2
0
第 1位 A 只有一个字符,不能是字符串本身,为 0;
第 2位 B 和 A 比较,不相等,为 0;
第 3位 A 和 A 比较,相等,所以相同前缀为 1;
第 4位 B 和前缀为 1 后的 B 比较,相等,和前缀组成了 AB 的相同模式的串,所以相同前缀为 2;
第 5 位 C 和前缀为 2 后的 A 比较,不相等,和前缀长度为 0 的比,相同前缀为0;
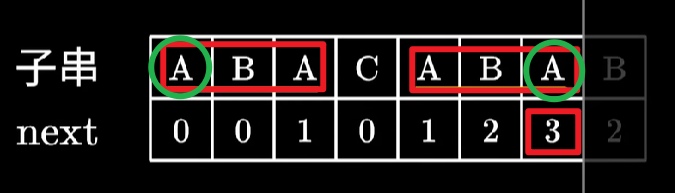
关于最长前缀的理解是,如下图所示。
最后一位的 A 很显然可以和 ABA 组成长度为 3 的相同前缀,也可以自己 A 组成长度为 1 的相同前缀。这种情况下选择较大的那个值。
求解next数组
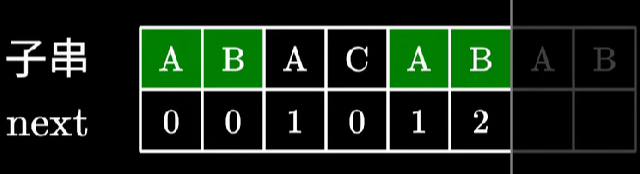
next 数组求解的本质是动态规划。假设我们已经知道当前数字的共同前后缀了,如下图所示。
接下来求第 i 位的 next 数组,分为两种情况。
下一位也和前缀相等
那就很明显等于 next[i−1] 加上 1。
下一位和前缀不相等
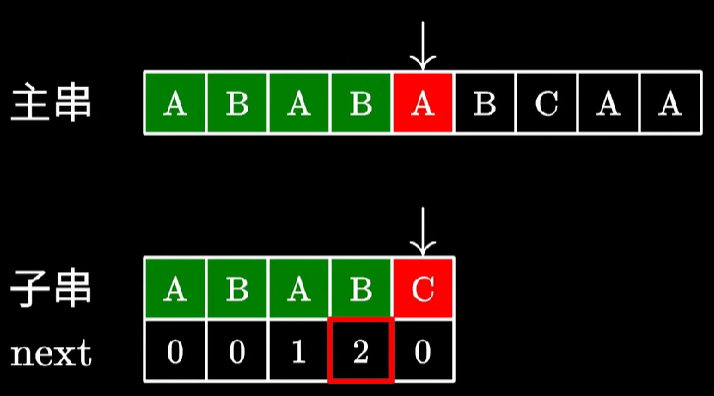
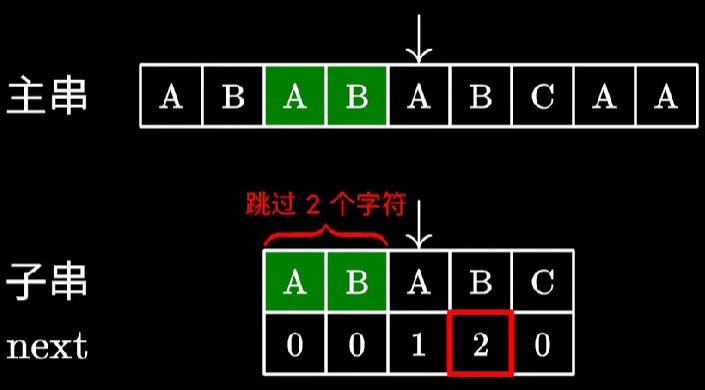
这里不是直接等于 0 哦。如下图所示
虽然 ABAB 和 ABAC 并不相等,但是也不能直接设为 0。因为这个新来的 B 可以和前面的 A 组成 AB,达到 2 的长度。那么这个数难道要暴力求解吗?其实不然。此时第 i−1 位的 next 的可利用的值在前缀的 next 数组中可以得到答案,在本图中为 next[2],即是 1。此时修改前缀长度为 next[2],则又回到了最开始的状况,匹配长度为 1 并且匹配下一位,下一位 B 相等,所以 next[i] 为 1+1=2。
代码如下:
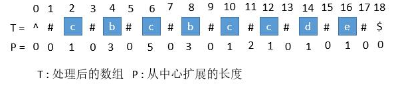
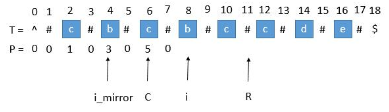
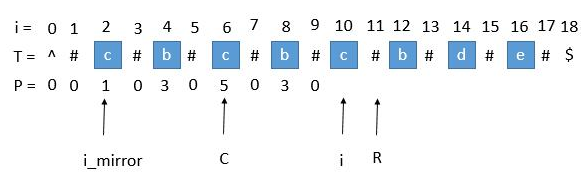
用 C 表示回文串中心 Centre,用 R 表示臂长右半部分下标边界,即 R=C+P[i]。C 和 R 对应当前循环中 R 最靠右的回文串(手最长的,能管这个数组到最远的,之所以可以保证复杂度是因为保证 R 不退缩)。
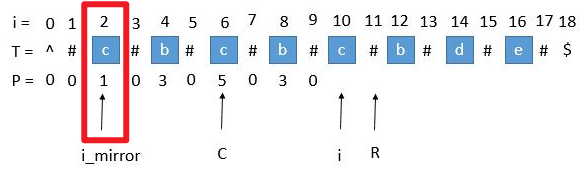
如图,在求 P[i] 时,用 i_mirror 表示要求的第 i 个字符关于 C 对应的下标。我们要求 P[i],用中心扩展法就是向两边伸长。但是可以利用已经求出来的回文串中心 C 的对称性,因为 P[i_mirror]=3,那干脆让 P[i]=3。有以下 3 中情况会导致这个直接赋值不正确:
1. 超出了 R
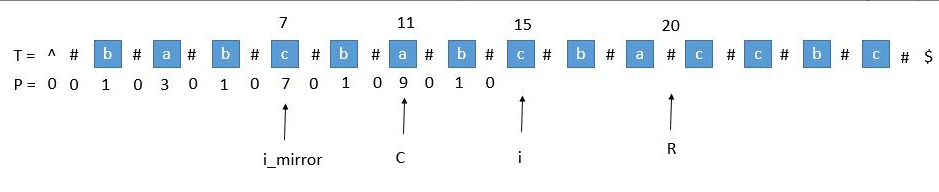
当求 P[i] 时,P[i_mirror]=7,但是却不应该等于 7,因为从 i 往后面数 7 个已经等于 22 了,然而 R 才到 20,很显然还没有探索到那里。但是可以保证我们一定可以扩展到 R(因为对称),所以 P[i] 至少可以为 5。剩下的只能中心扩展了。
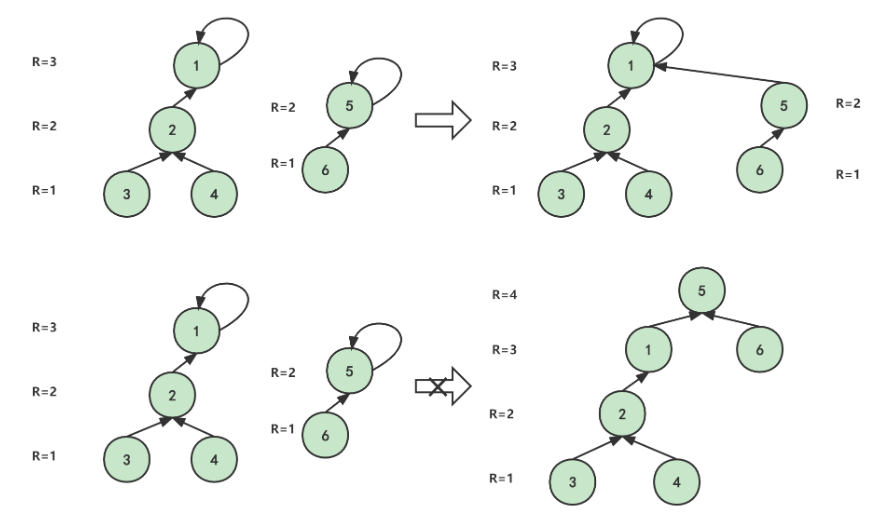
voidmerge(int a, int b){ int x = find(a); int y = find(b); if (x == y) { return; } // 比高度 if (rank[x] < rank[y]) { parent[x] = y; } else { parent[y] = x; if (rank[x] == rank[y]) { rank[x]++; } } }
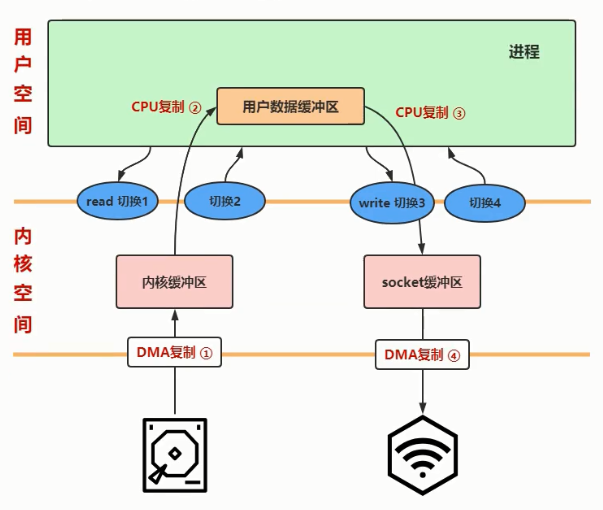
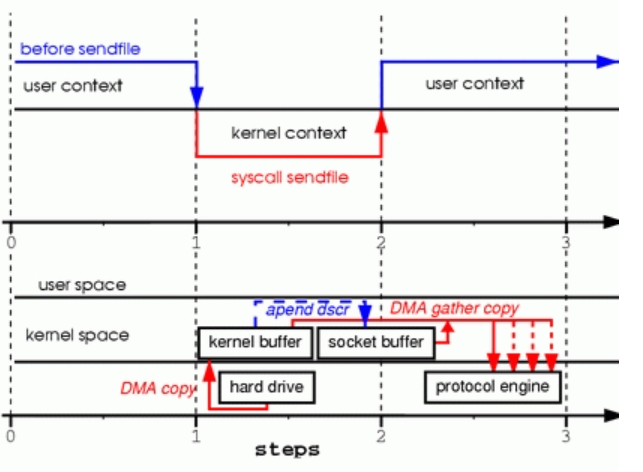
直接内存访问(Direct Memory Access)是一种执行 I/O 的工作方式。在这种方式中,DMA 控制器从 CPU 完全接管对总线的控制。这意味着数据交换不经过 CPU,而直接在内存和 I/O 设备之间进行 。DMA 方式一般用于高速传送成组数据。DMA 控制器将向内存发出地址和控制信号,修改地址,对传送的字的个数计数,并且以中断方式向 CPU 报告传送操作的结束。
DMA 方式的主要优点是速度快。由于 CPU 根本不参加传送操作,因此就省去了 CPU 取指令、取数、送数等操作。在数据传送过程中,没有保存现场、恢复现场之类的工作。内存地址修改、传送字个数的计数等等,也不是由软件实现,而是用硬件线路直接实现的。所以 DMA 方式能满足高速 I/O 设备的要求,也有利于 CPU 效率的发挥。
用户态和内核态
在 Linux 系统中,有的程序权限很高,可以访问计算机的任何资源,但是有的程序权限就低,只能访问部分资源。这两个类型的程序,就可以映射为用户态和内核态。内核态是计算机的核心,可以访问计算机的任何资源,如网卡、硬盘。为了安全,CPU 不能让用户程序肆无忌惮的访问计算机的任何资源,这样如果用户程序不稳定可能会造成系统崩溃,因此才有的用户态。
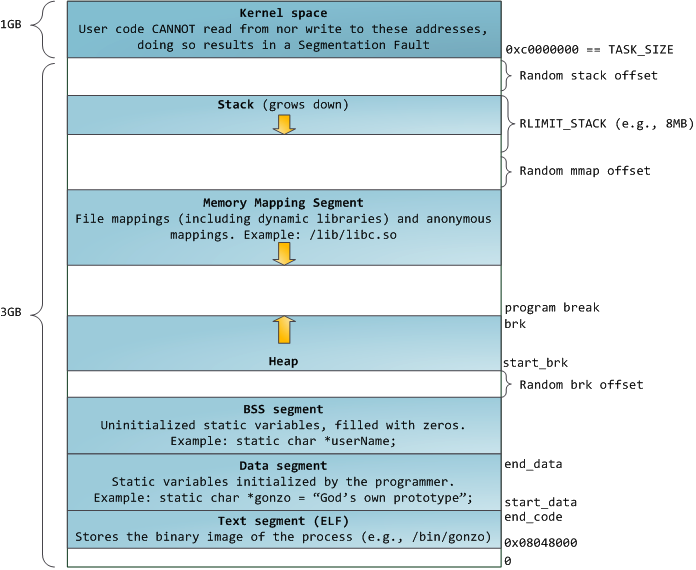
堆同栈一样,都是为进程运行提供动态的内存分配,但其和栈的的一个很大区别在于堆上内存的生命周期和执行分配的函数的生命周期不同,堆上分配的内存只有在对应进程通过系统调用主动释放或进程结束后才会释放。堆的内存分配效率比栈要低得多。因为栈是由操作系统提供管理的,会在底层堆栈提供支持,分配专门的寄存器($esp)存放栈的地址,包括压栈出栈也都有专门的指令执行,所以执行效率很高。而堆则是由 C 函数库提供支持,它的机制相对复杂,例如分配一块内存,库函数会按照一定的算法在堆内存空间中搜索可用的足够大的内存空间,如果没有足够大的连续空间,则需要操作系统来重新整理堆内存,这样才有机会分到足够大小的空间,然后才返回。对于堆来说,频繁的 malloc/free(new/delete)势必会造成内存空间的不连续,从而造成大量的内存碎片,程序的运行效率降低。而对于栈来说,分配的一定是连续的内存空间。
BSS段
堆段再往下便是 BSS 段这个静态内存区域,它是用来存储静态局部或静态全局变量的,其在编译期间便决定了虚拟内存的消耗,BSS 段存放的是未初始化的变量。另外根据 C 语言标准规定,未初始化的静态成员变量的初始值必须为 0,所以内核在加载二进制文件后执行程序前会将 BSS 段清 0。
DATA段
DATA 段也是个静态内存区域,也是用来存储静态局部或静态全局变量。但是放的是已经初始化的变量。
代码段
DATA 段再往下便是代码段,这段中存有程序的指令代码。TEXT 段是通过只读的方式加载到内存中的,它可以在多个进程中被安全共享。