一、概览
V1 不是给 V0 打补丁,而是把 scheduler / KV cache manager / worker / sampler / API server 全部重写了一遍。动机很直接:V0 时代各特性是各自独立开发的,横向堆了很多,但纵向组合起来越来越难;推理请求一多、模型一小,CPU 开销反而成了瓶颈。
| # | 特性 | V1改动 | V0问题 |
|---|---|---|---|
| 1 | EngineCore 进程隔离 | API server 与执行循环拆成两个进程 | GPU 只要 5ms,CPU 却来不及喂 |
| 2 | 统一 token 预算的 scheduler | 不再区分 prefill / decode,统一按 token 数调度 | 特性之间难以组合 |
| 3 | 零开销 prefix caching | 命中率 0% 时吞吐也只掉 <1% | V0 里开了反而变慢,只好默认关 |
| 4 | 对称的 TP 架构 | scheduler 与 worker 0 分进程,只传增量 | V0 里 scheduler 和 worker 0 必须挤在一个进程 |
| 5 | Persistent Batch | 输入张量不再每步重建,只打 diff | 每步重建输入的 CPU 开销 |
| 6 | torch.compile + 分段 CUDA Graph | 自动编译 + 绕过 CUDA graph 的静态限制 | 模型多、手写 kernel 维护不动 |
二、详细内容
1. EngineCore:把「调度」从 API 里抠出来
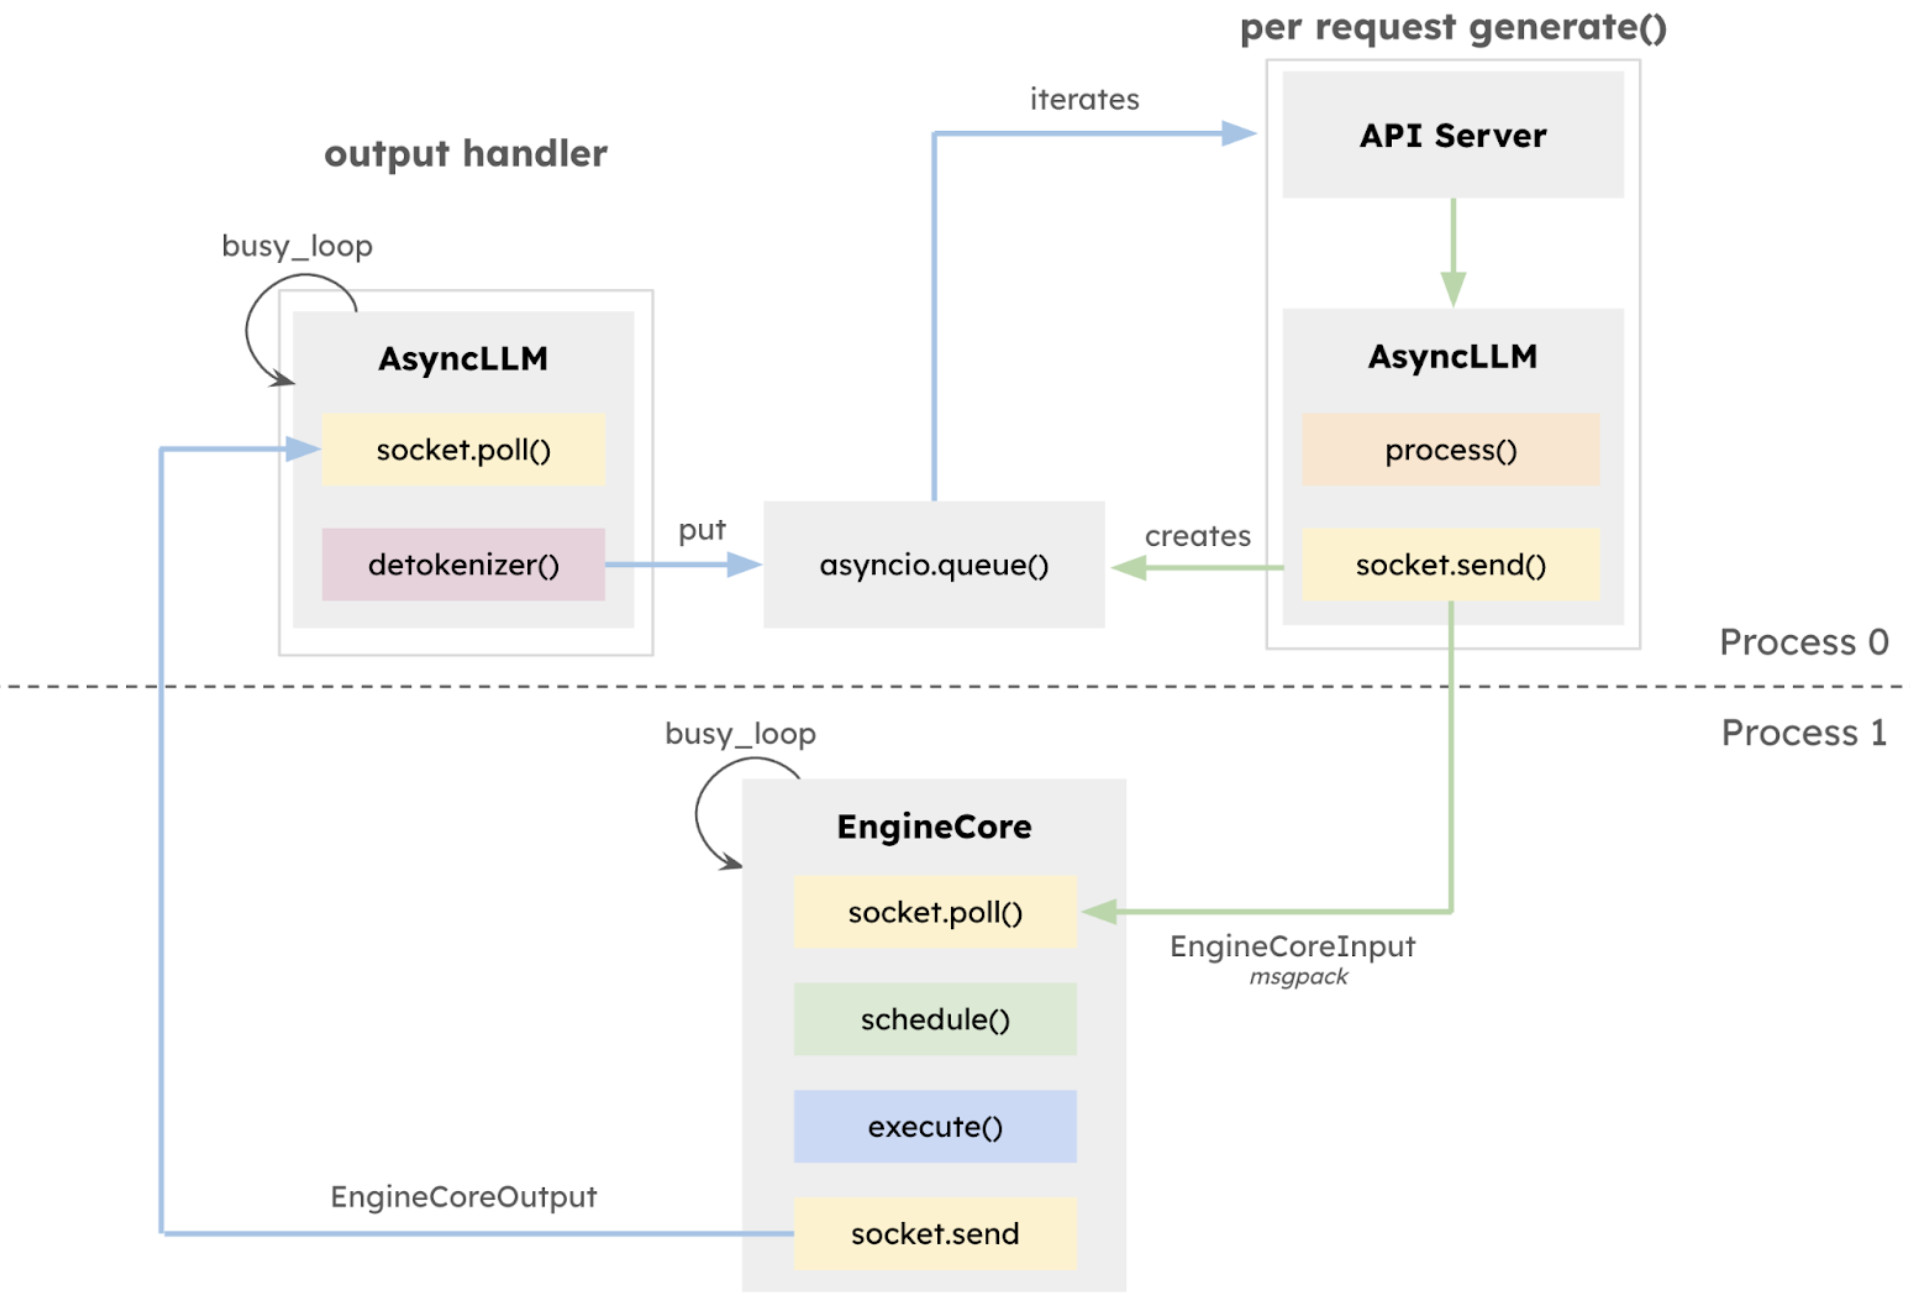
V0 里 API server、调度、输入准备、detokenize、流式输出都挤在同一个异步循环里。GPU 越来越快(H100 上 Llama-8B 一次前向只要 ~5ms),这些 CPU 工作就成了新的瓶颈。V1 把 EngineCore 拆成独立进程,只做 scheduler + model executor,其余 CPU 密集的活(tokenize、多模态预处理、detokenize、请求流式返回)留在外面的进程重叠执行。
Python 的全局解释器锁(GIL) 决定了在同一个进程内,即使开多线程,纯 Python 代码在任意时刻也只能有一个线程执行。
V0 把所有逻辑放在一个异步循环中,tokenize、调度、detokenize 等纯 Python 操作会串行争抢 GIL,CPU 无法真正并行,成为 GPU 的“拖油瓶”。
V1 将前端(API Server)和 EngineCore 置于不同的操作系统进程中。每个进程有自己独立的 GIL,因此前端的 tokenize、多模态预处理、detokenize 和流式返回等 CPU 密集型工作,可以与 EngineCore 进程中的调度和模型执行在不同 CPU 核心上真正同时运行,不再互相阻塞。
2. Scheduler:从「阶段」变成「token 预算」
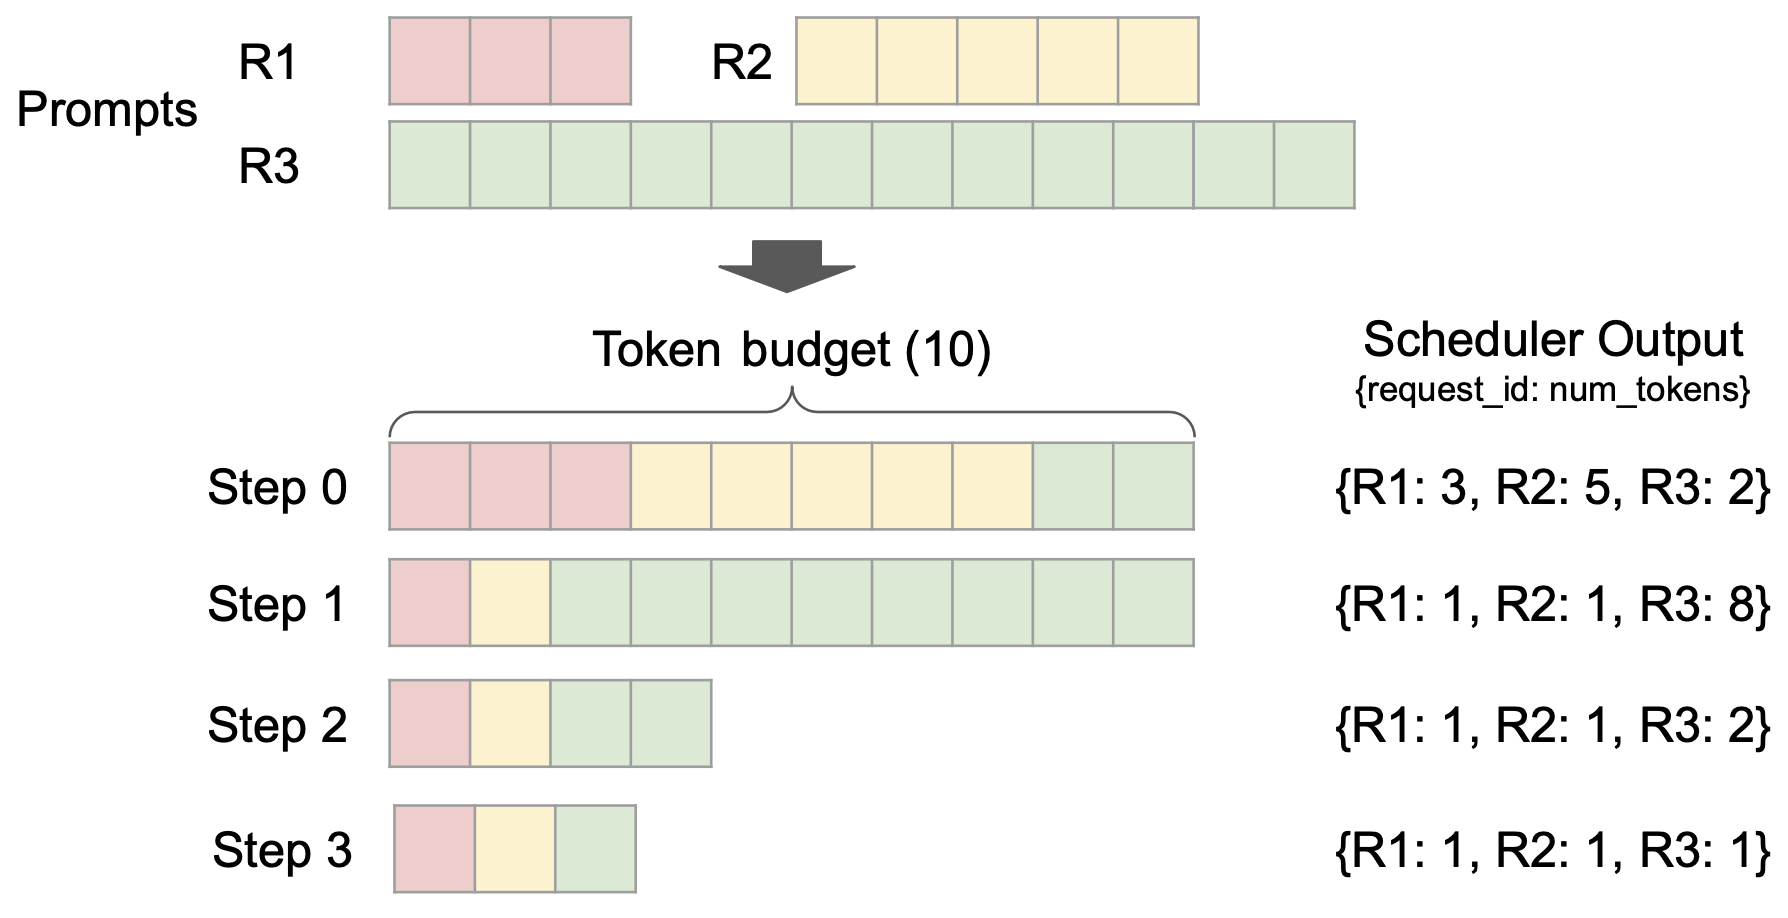
V1 的调度结果就是一个字典 {request_id: num_tokens}——这一步每个请求各跑几个 token。prompt token 和生成 token 同等对待,于是 chunked prefill、prefix caching、投机解码全都能落在同一个表示上:给定 token 预算,scheduler 自己决定每个请求分多少。
3. Prefix Caching:从「默认关」变成「默认开」
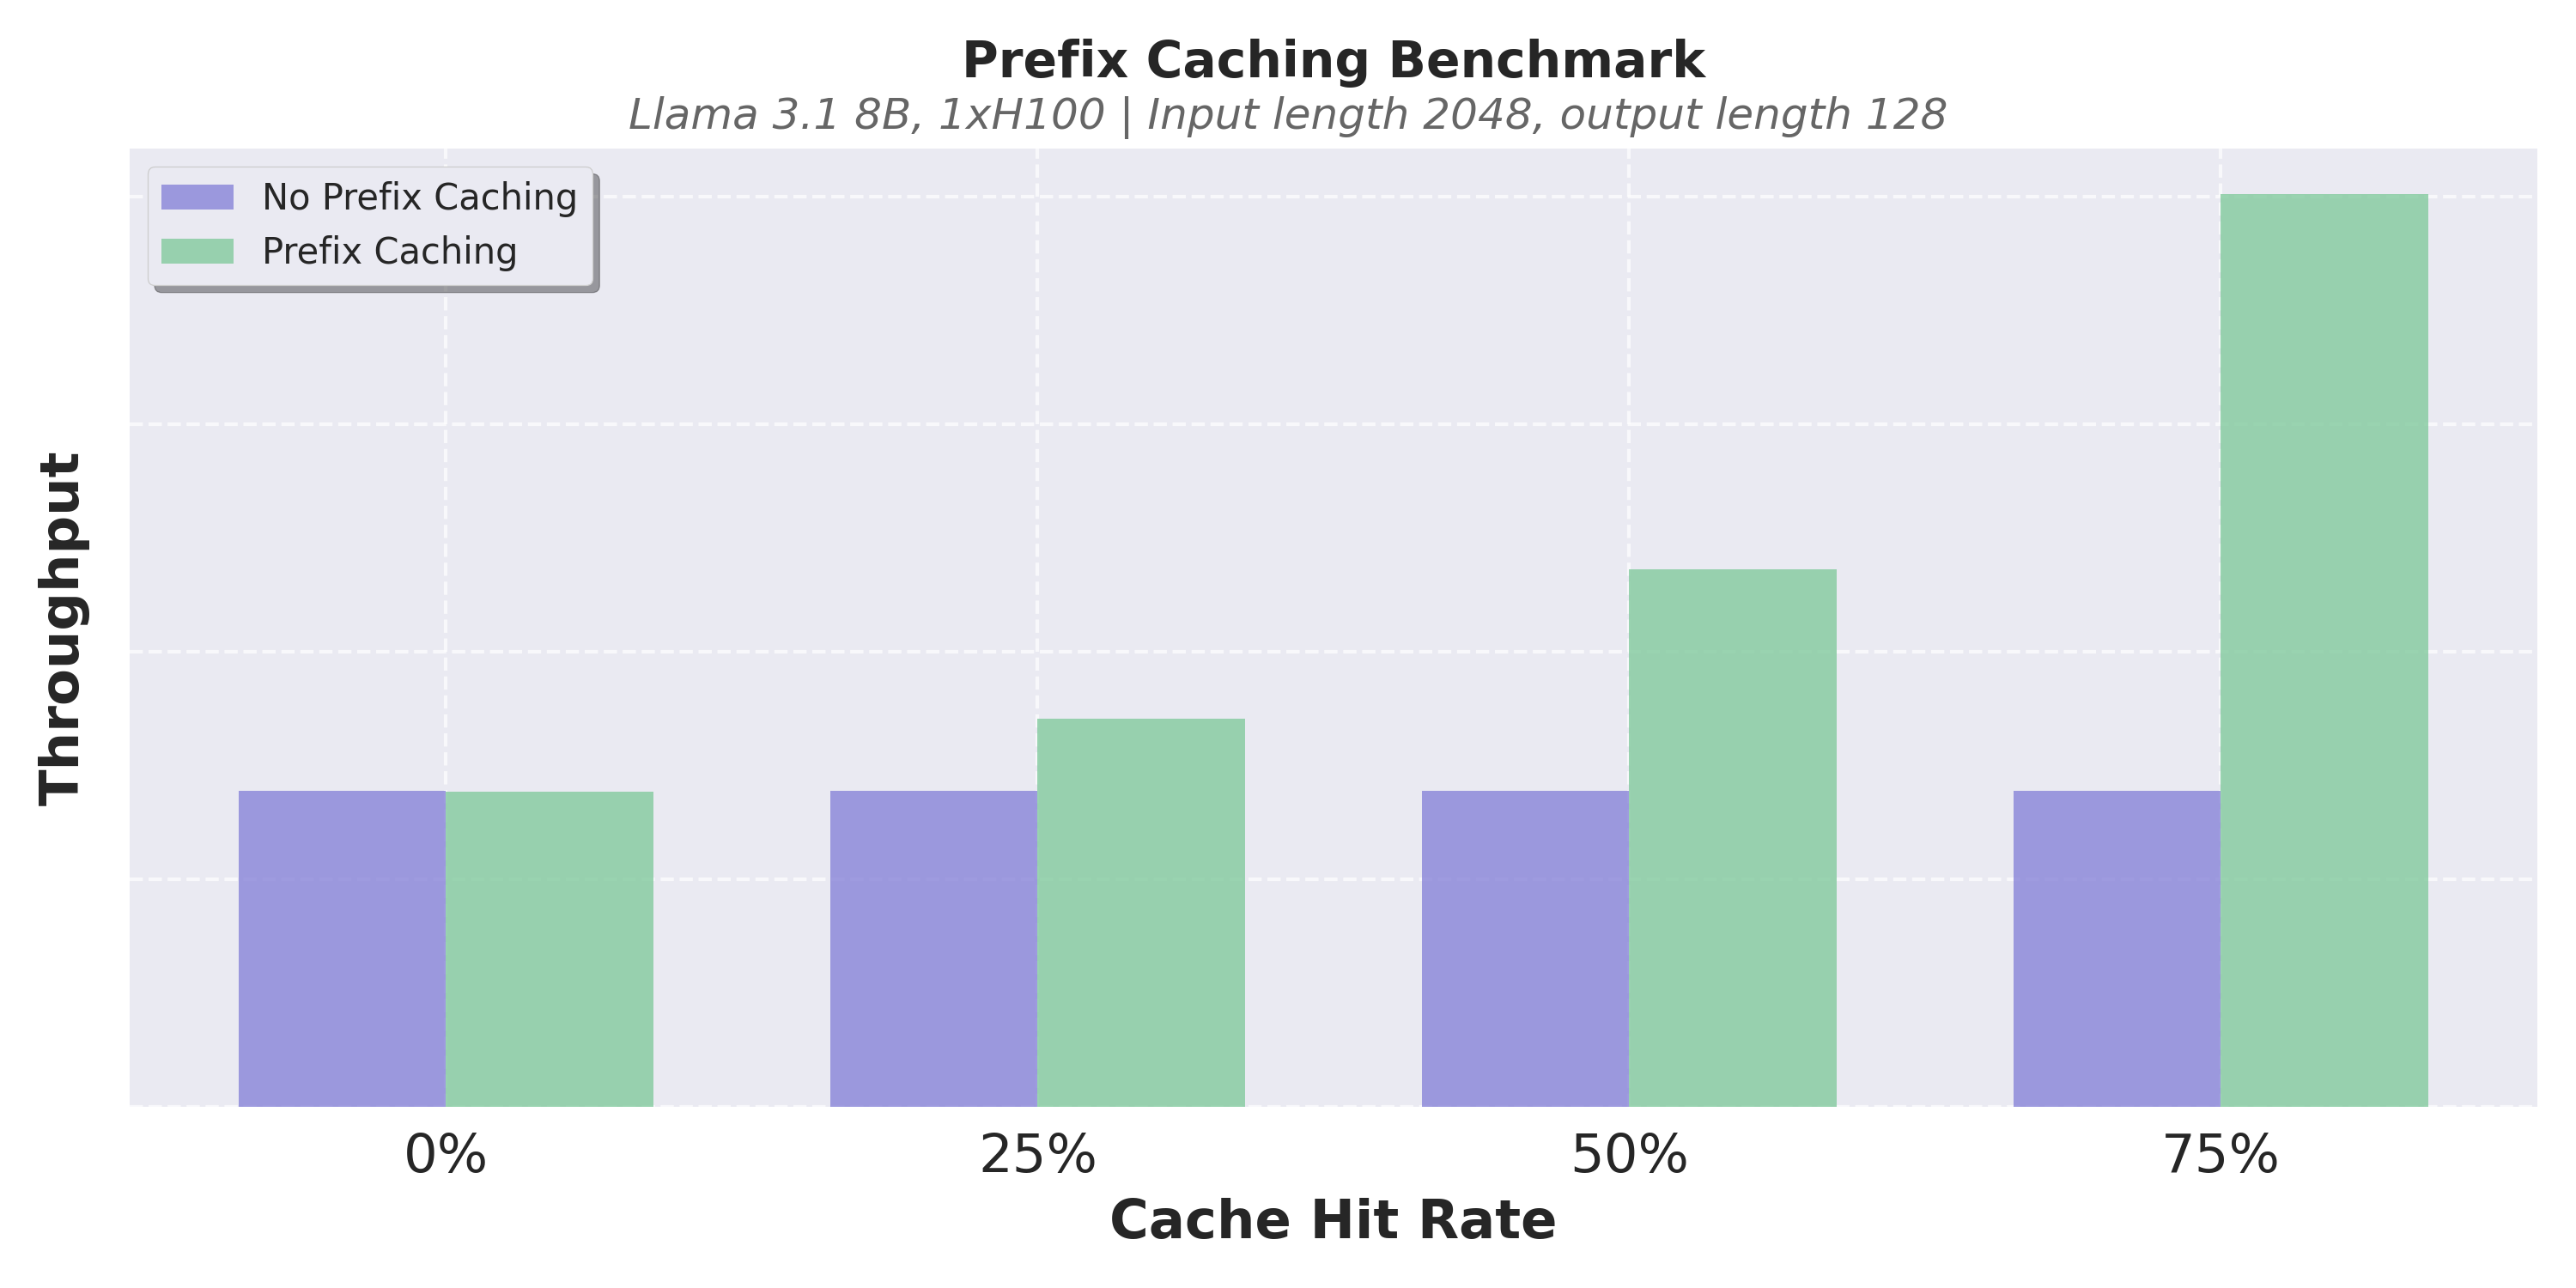
V0 的 hash 前缀缓存 + LRU 淘汰在命中率低时 CPU 开销很明显,所以默认关闭。V1 把淘汰做成常数时间、尽量少建 Python 对象,命中率 0% 时吞吐损失 <1%,命中率高时吞吐翻几倍——于是 V1 直接把它设成默认开启。
为什么「常数时间」是可能的? 关键在于 V1 把 KV cache 管成固定数量的定长 block,每块带两个字段:一个 hash(可以是空),和一个双向链表指针。分配时只看空闲队列的队头,从不全局搜索 LRU:
- 队头是「无 hash 的空块」→ 直接分配,O(1);
- 队头是「有 hash 的已缓存块」→ 它就是 LRU 候选:
- 若是最后一份:把 hash 从
hash → block表里删掉、清空该块,腾出来用; - 若不是:只把引用计数减一,把它挪开,看下一个队头。
两种情况都是 O(1)。
- 若是最后一份:把 hash 从
需要「淘汰」这件事只在队头发生,而队头的选择是链表操作,所以没有 O(n) 的扫描。命中时把块从队列里摘出来复用,释放时再挂回队尾——同样是 O(1)。V0 的开销主要来自每个 block 每步都新建 Python 对象、做 dict/hash 操作、复制 block table;V1 把这些压成 C 层的链表/字典操作,block table 增量更新,并把 Python 对象创建降到最低,于是「没命中」也几乎不花钱。
4. Tensor Parallel:从「非对称」变成「对称」
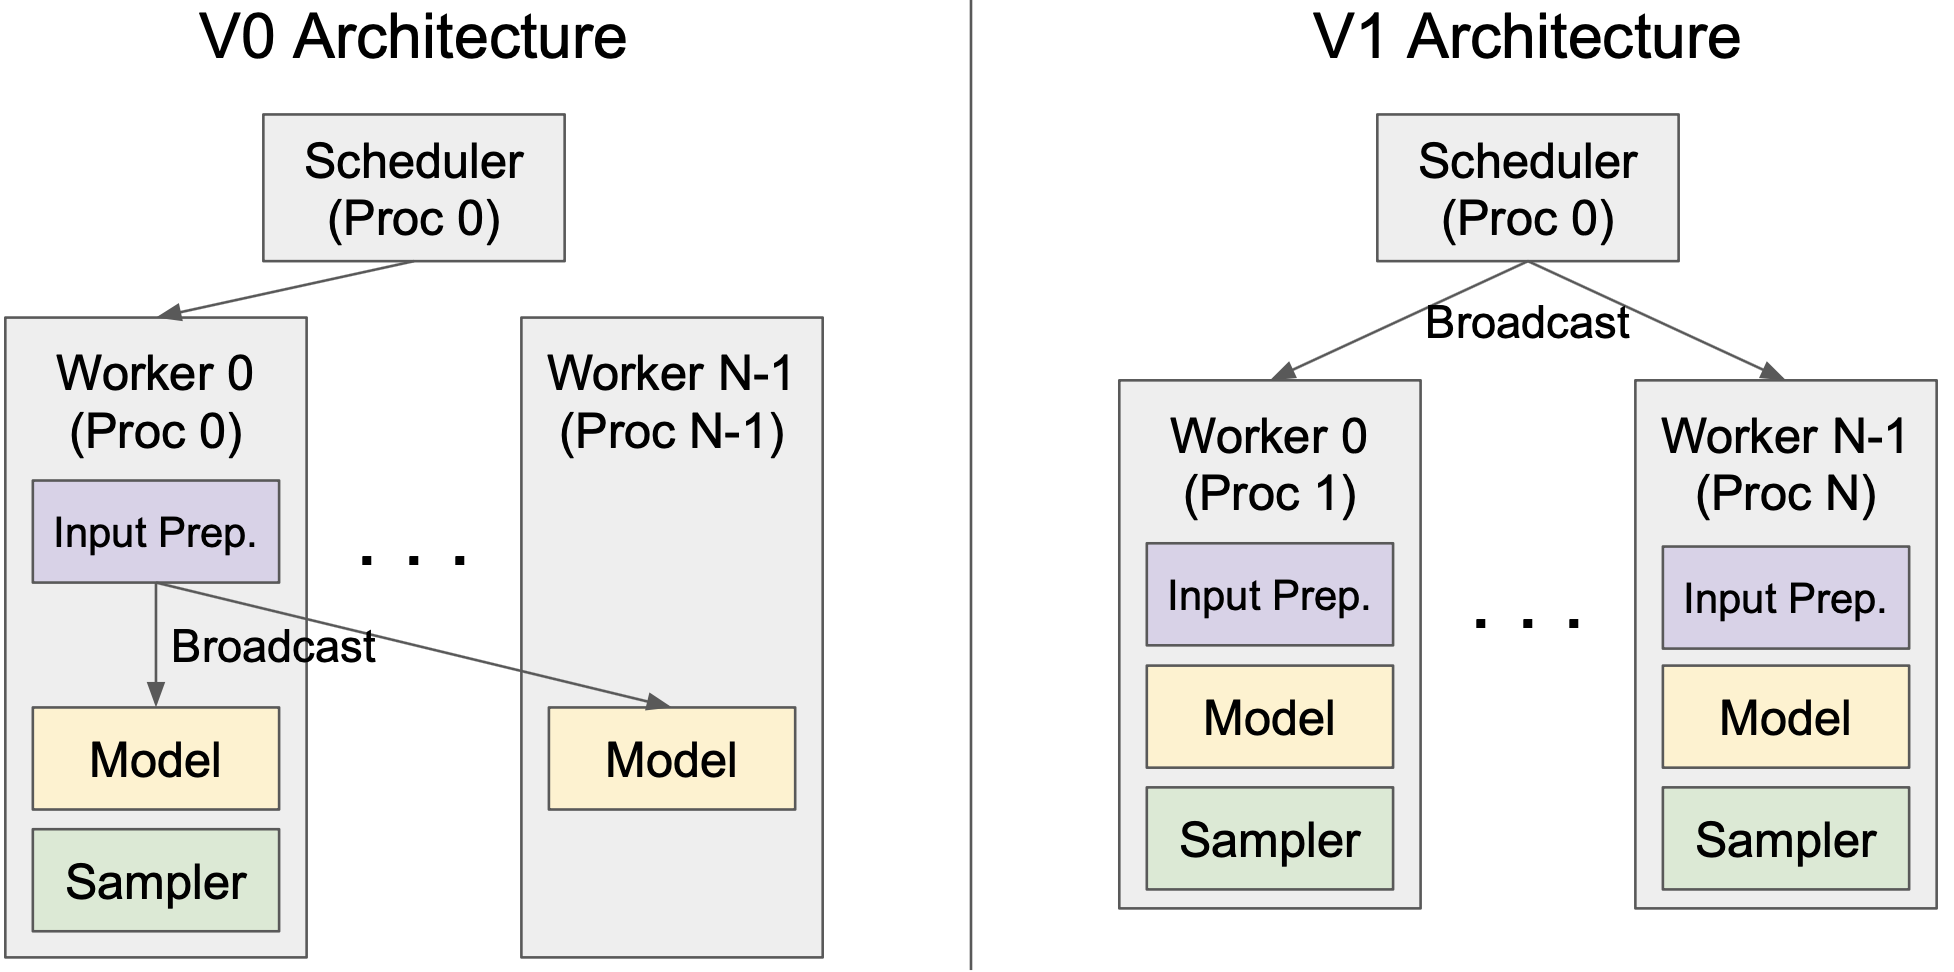
V0 为了省一次广播,把 scheduler 和 worker 0 放在同一进程,结构天然不对称。V1 改成每个 worker 自己缓存请求状态、每步只传增量(diff),于是 scheduler 和 worker 0 也能分进程,所有 worker 长得一样;单卡和多卡走同一套代码路径。
5. Persistent Batch:输入张量只打补丁
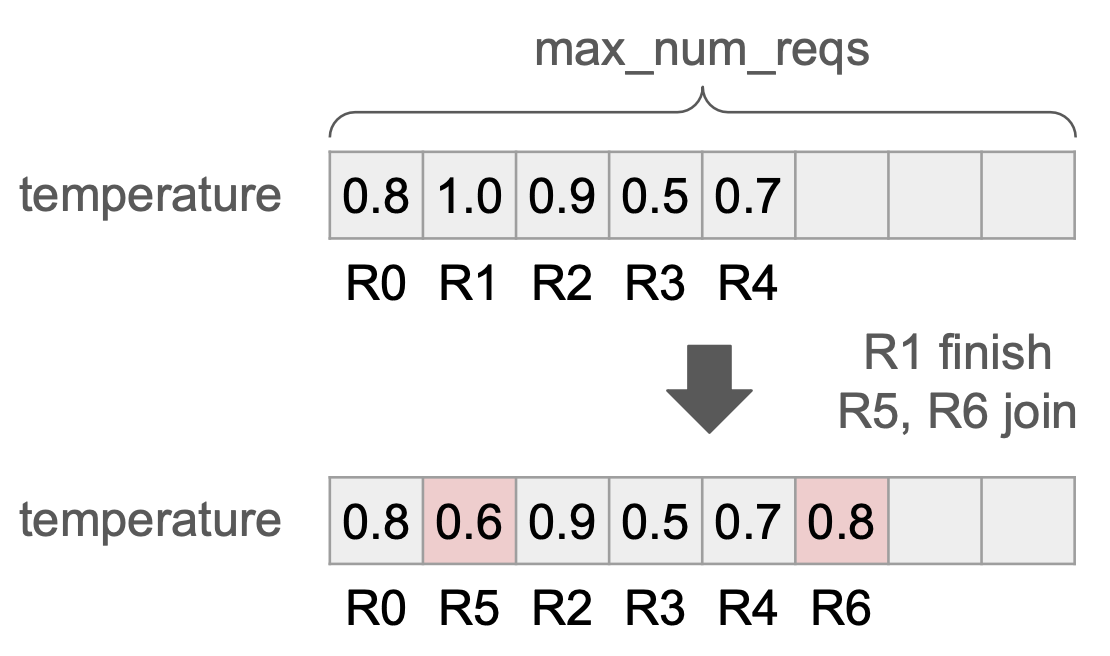
V0 每步都重建输入张量和 metadata。V1 借鉴 LMDeploy 的 Persistent Batch:缓存上一轮的输入张量,每步只把变化写进去,并且大量用 Numpy 操作替代 Python 原生循环。
6. torch.compile + 分段 CUDA Graph
V1 直接吃 vLLM 的 torch.compile 集成来自动优化模型,减少手写 custom kernel 的负担;再用分段(piecewise)CUDA Graph 缓解 CUDA graph 对动态 shape 的限制——图里静态的部分走 graph,动态的部分(如 attention)单独执行。
V1 的几种「分图方式」(compilation_config.cudagraph_mode):
| 模式 | 捕获范围 | 适合的场景 | 代价 |
|---|---|---|---|
NONE |
完全不捕获,纯 eager | 调试、对 CUDA graph 不友好的自定义算子 | 每步 kernel launch 开销全暴露 |
PIECEWISE |
把模型在 attention 处切开,每个静态片段单独一张 graph,attention 留在 graph 外 eager 执行 | shape 变化多(prefill/decode 混跑) | attention 那一段仍有 launch 开销 (Attention 算子的动态性(变长、变 batch)与 CUDA Graph 对静态形状的硬性要求存在根本冲突。) |
FULL |
整段 forward 含 attention 一起捕获成一张 graph | decode-only、形状稳定的热路径 | 要求 attention backend 支持 CUDA graph(fa3);形状一变就得换/重捕 |
FULL_AND_PIECEWISE |
两套 graph 都备好,运行时按 batch descriptor 自动选:纯 decode 走 FULL,混合 batch 退回 PIECEWISE | 生产默认 | 多占一份显存与预热时间 |
细节见官方设计文档 CUDA Graphs。
三、发展历史
V1 alpha(2025-01)时缺 log probs、pipeline parallelism、结构化输出、投机解码、Prometheus metrics、LoRA,且只支持 Ampere 及以后的 NVIDIA GPU。但这些问题后来都补上了,时间线很清楚:
| 时间 | 事件 |
|---|---|
| 2025-01 | V1 alpha 发布,VLLM_USE_V1=1 开启,API 零改动 |
| v0.8.0 | V1 成为默认引擎(见 RFC #18571) |
| v0.9.0 | V0 代码冻结,只接受 bugfix |
| v0.10.0 | 正式宣布废弃,开始删 V0 代码 |
| v0.11.0 | V0 代码(AsyncLLMEngine、LLMEngine、MQLLMEngine、旧 attention backend 等)全部删除,V1 是唯一的引擎(release notes) |