Attention Residuals

出处:Attention Residuals arXiv:2603.15031、官方实现 MoonshotAI/Attention-Residuals;K3 用 Block 版本。
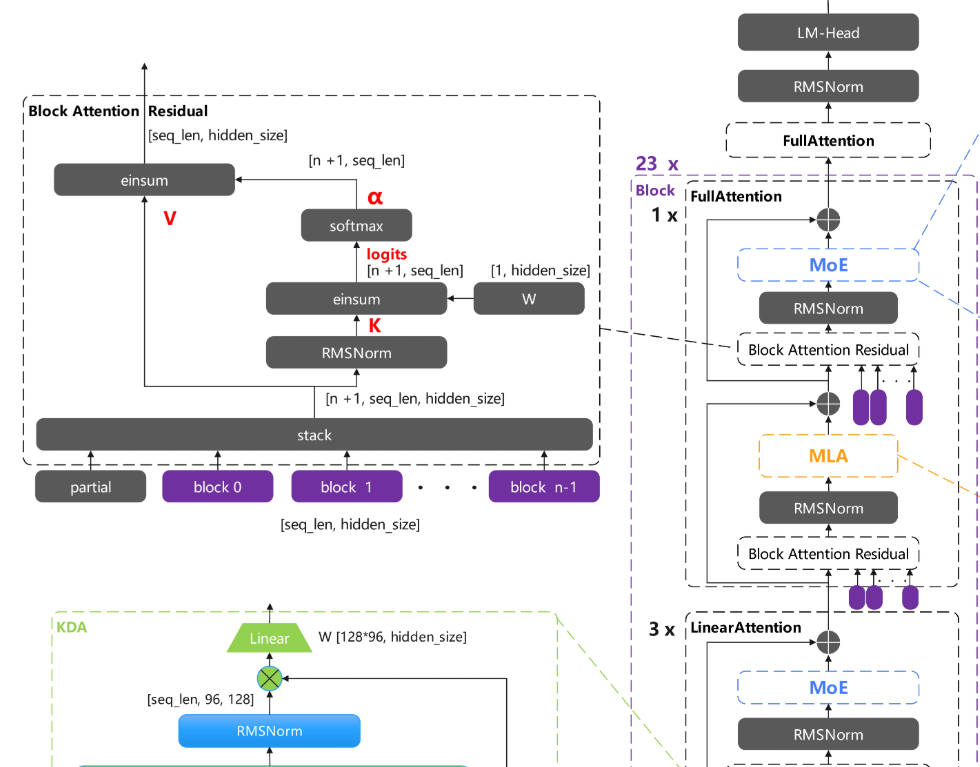
Block Attention Residual 内部,以及它在一层里的位置

核心思想

残差真的需要把之前每一层的信息都加进来吗?每一层的信息都同样重要吗?hidden_states中的信息在被逐渐稀释。
attention residual的思想是,不再像传统一样的残差,而是根据当前层向之前的层的残差做一次attention,让每一层有针对性地关注自己想要的残差信息。

伪代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 常驻状态(每 token 一份,与序列长度无关)
# emb : [d] embedding,bank[0],永远在栈底
# bank : [n][d] 已完成的块表示(K3:12 层一块,共 8 块)
# partial : [d] 当前块的运行和,块边界处入栈

v = [emb] + bank + [partial] # stack:图中底部那一摞,n+1 份 [d]
k = rmsnorm(v) # RMSNorm:得出 k

logits = k @ w # w 其实就是 query
alpha = softmax(logits) # alpha 其实是 attention score
h = v @ alpha # 得出注意力结果

if layer.idx % 12 == 0: # 块边界:攒满 12 层的运行和入栈,开新块
bank.append(partial)
partial = zeros()